Prompt yazmayı bırak, ajan döngüleri kurmaya başla
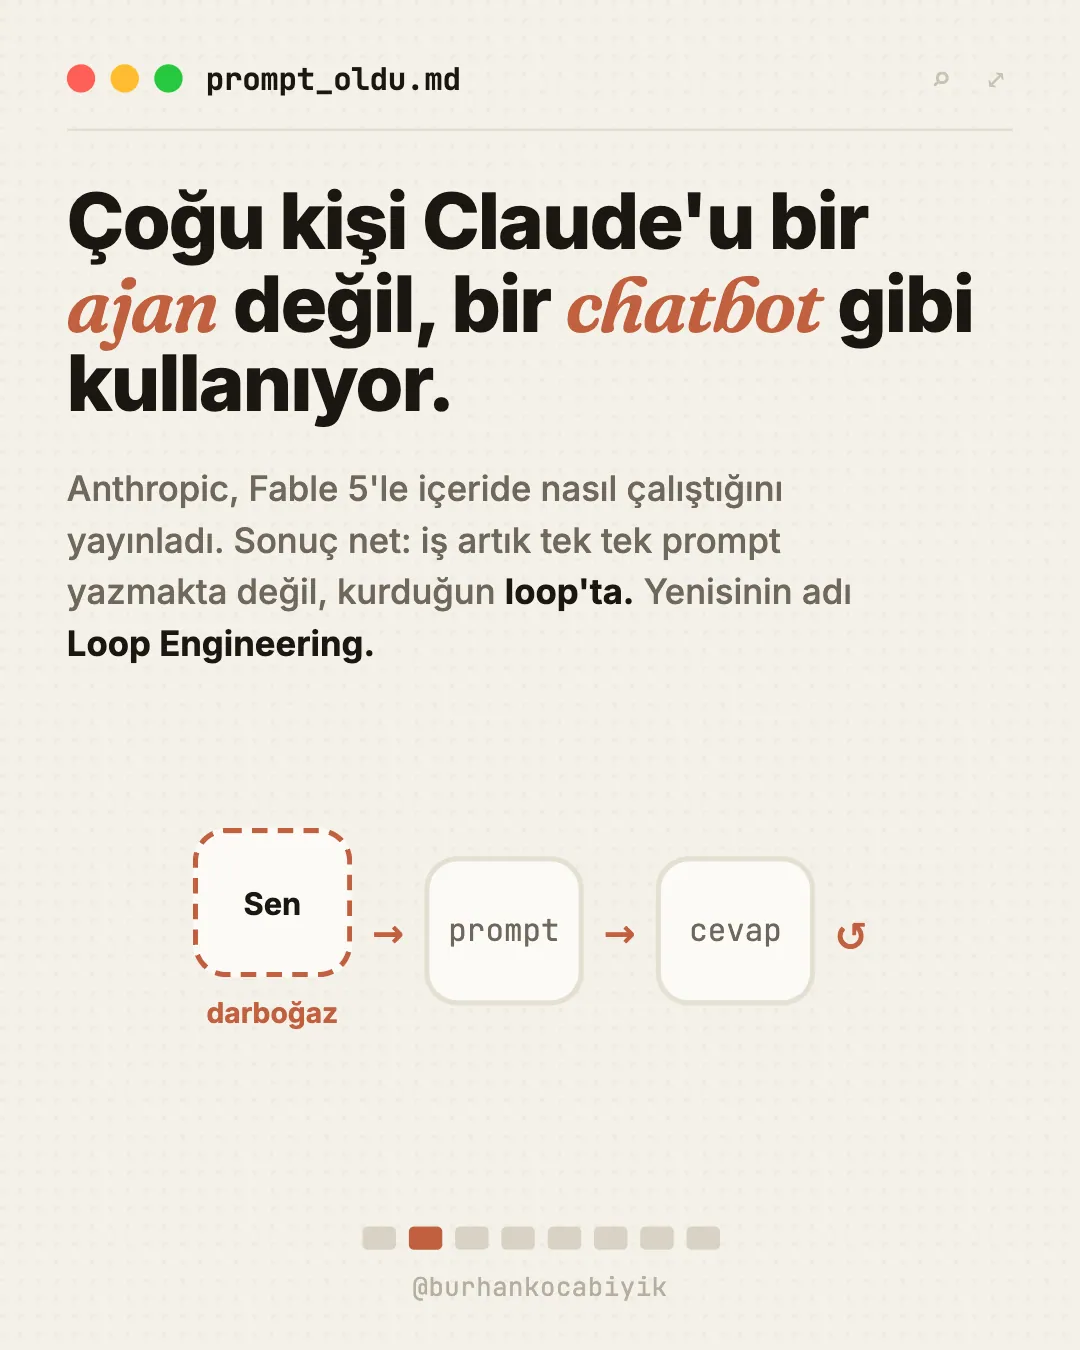
Anthropic, Fable 5 ile içeride nasıl çalıştığını yayınladı ve sonuç net: bir iş birimi olarak prompt öldü. Yenisinin adı Loop Engineering. Bu yazıda ne olduğunu, nasıl çalıştığını ve bugün kendi döngünü nasıl kuracağın, adım adım.
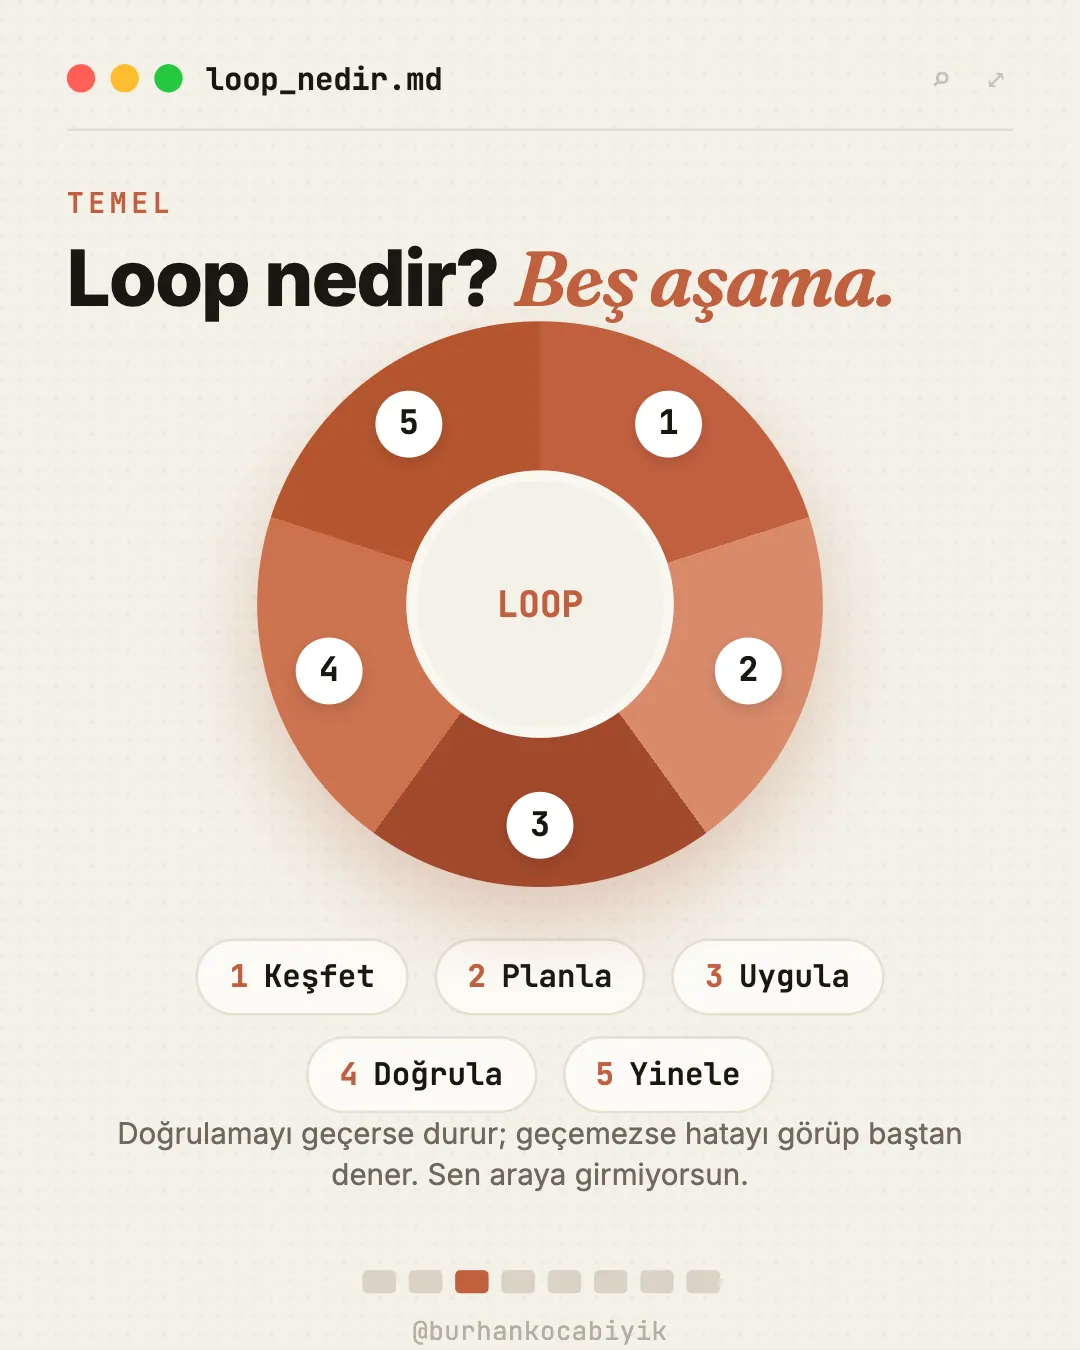
Son iki yıldır ajanlarla çalışma şeklimiz şuydu: prompt yaz → ajan cevaplasın → sen incele → düzelt → tekrar yaz. Darboğaz sensin. Loop Engineering bunu tersine çeviriyor: ajana talimat değil, doğrulanabilir bir iş veriyorsun ve o, hedefe ulaşana kadar döngüyü kendi çeviriyor. Her loop beş aşamadan geçiyor: keşfet → planla → uygula → doğrula → yinele. Anahtar kelime "doğrulanabilir": "güzel bir landing yap" değil, "/auth testlerinin hepsi geçsin ve lint temiz olsun". Fable 5 bu işte fark yaratıyor çünkü sadece tekrar etmiyor; yapısal riskler alıp hatadan loop'un içinde toparlanıyor. İki altın kural: (1) yapan, yargılayan olamaz, bağımsız bir doğrulayıcı şart; (2) hafıza oturumlar arası yaşamalı. Bugün başlamak için Claude Code'da /goal veya Claude Managed Agents'ta Outcomes yeterli.
Hızlı Hook: Anthropic'in bu içsel çalışma notunun özü şu: Mesele "daha iyi prompt yazmak" değil; mesele kendini döngünün dışına çıkarmak. Çünkü güvenilir bir loop, bin mükemmel prompt'tan değerli.
Problem: loop sensin
Bir prompt ajana talimat verir; bir loop ona iş verir. Şu ana kadar her iterasyon senin elinden geçti: yazdın, ajan cevapladı, sen kontrol ettin, düzelttin, yeniden yazdın. Ajan denemeler arasında hiçbir şey öğrenmedi ve vaktin yarım işleri incelemekle geçti. Darboğaz tam olarak sensin.
Loop nedir (basitçe)?
Loop, ajanın doğrulanabilir bir hedefe ulaşana kadar tek başına tekrarladığı bir geri bildirim çevrimidir. Basit ya da karmaşık, tüm loop'lar aynı beş aşamadan geçer:
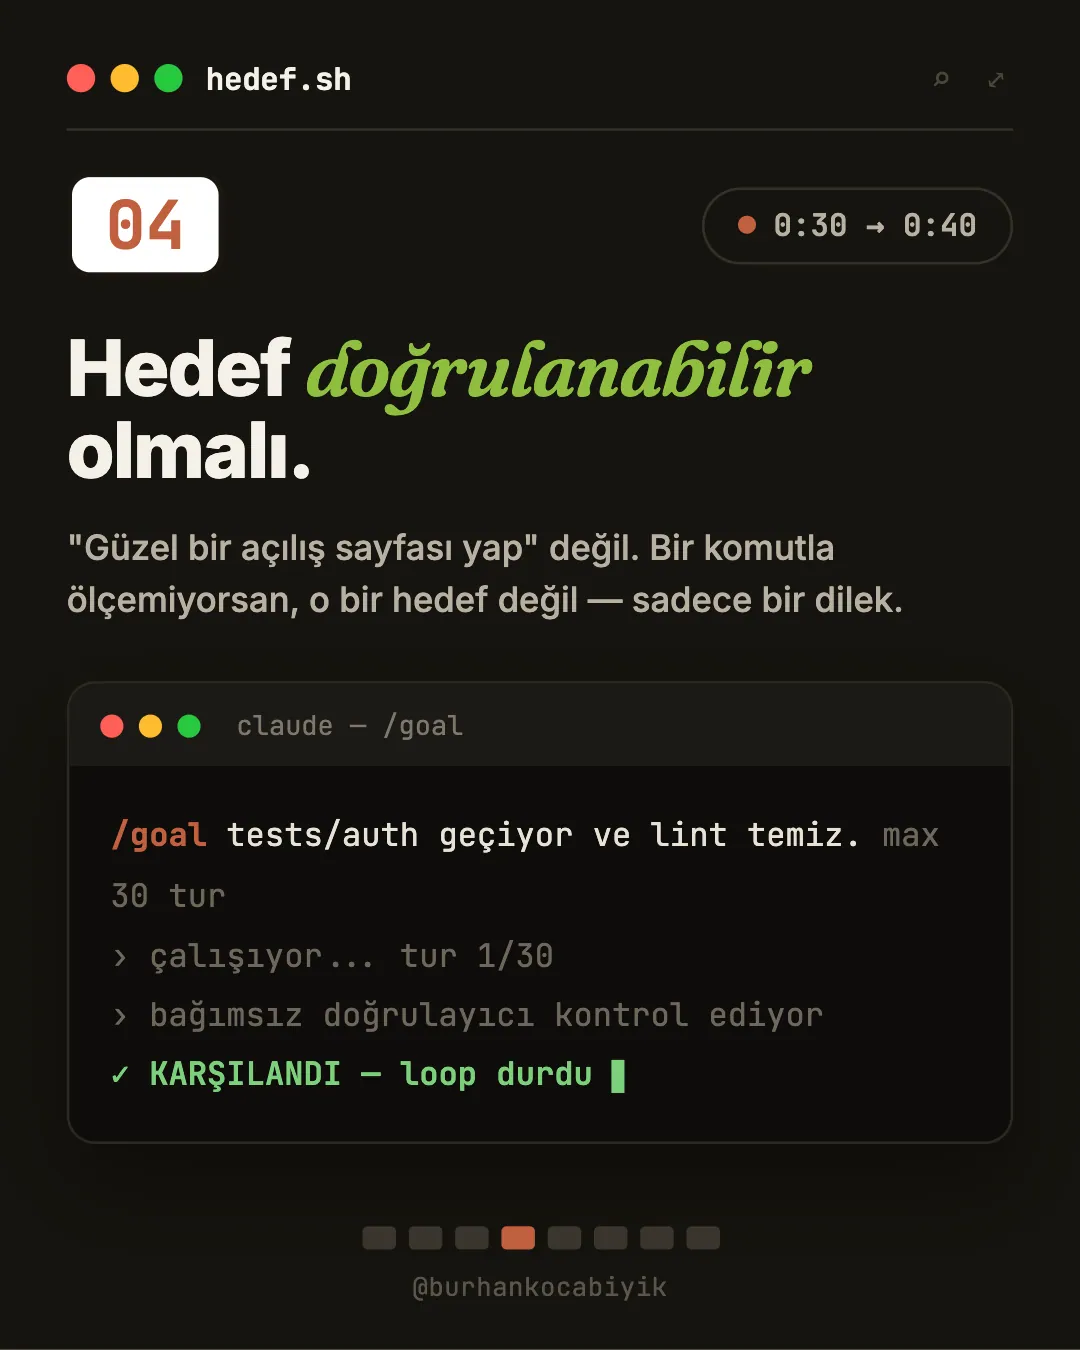
Doğrulamayı geçerse biter; geçemezse hatanın geri bildirimiyle baştan başlar. Anahtar kelime "doğrulanabilir". "Güzel bir landing yap" değil; "/auth testlerinin hepsi geçsin ve lint temiz olsun". Ajan tam olarak ne zaman bittiğini biliyor ve sen ortada değilsin.
Fable 5 neden oyunu değiştiriyor?
Anthropic, Fable 5'i Opus 4.7'ye karşı gerçek bir görevde denedi: Parameter Golf. Görev, 16MB'a sığan, 8 H100 GPU üstünde 10 dakikadan kısa eğitilen en iyi modeli üretmek. Ajan eğitim kodunu düzenleyecek, eğitimi başlatacak, logları okuyacak, skoru görüp bir sonraki deneyi seçecekti. 8 saat boyunca. Tek başına.
Fable 5, pipeline'ı Opus 4.7'den yaklaşık 6 kat daha fazla iyileştirdi. Parameter Golf sonucu
Ama önemli olan sayı değil, nasıl'ı: Opus 4.7 başta küçük bir iyileşme bulup aynı kalıbı 20 kez tekrarladı (bir parametreye dokun, ölç, faydalıysa tut). Fable 5 ise büyük yapısal değişikliklere oynadı (sabitlere değil mimariye) ve sonradan en büyük zaferi olan bir nicemleme (quantization) gerilemesine katlandı. Fable 5 sadece yinelemiyor; risk alıyor ve hatadan loop'un içinde toparlanıyor.
Altın kural: yapan, yargılayan değildir
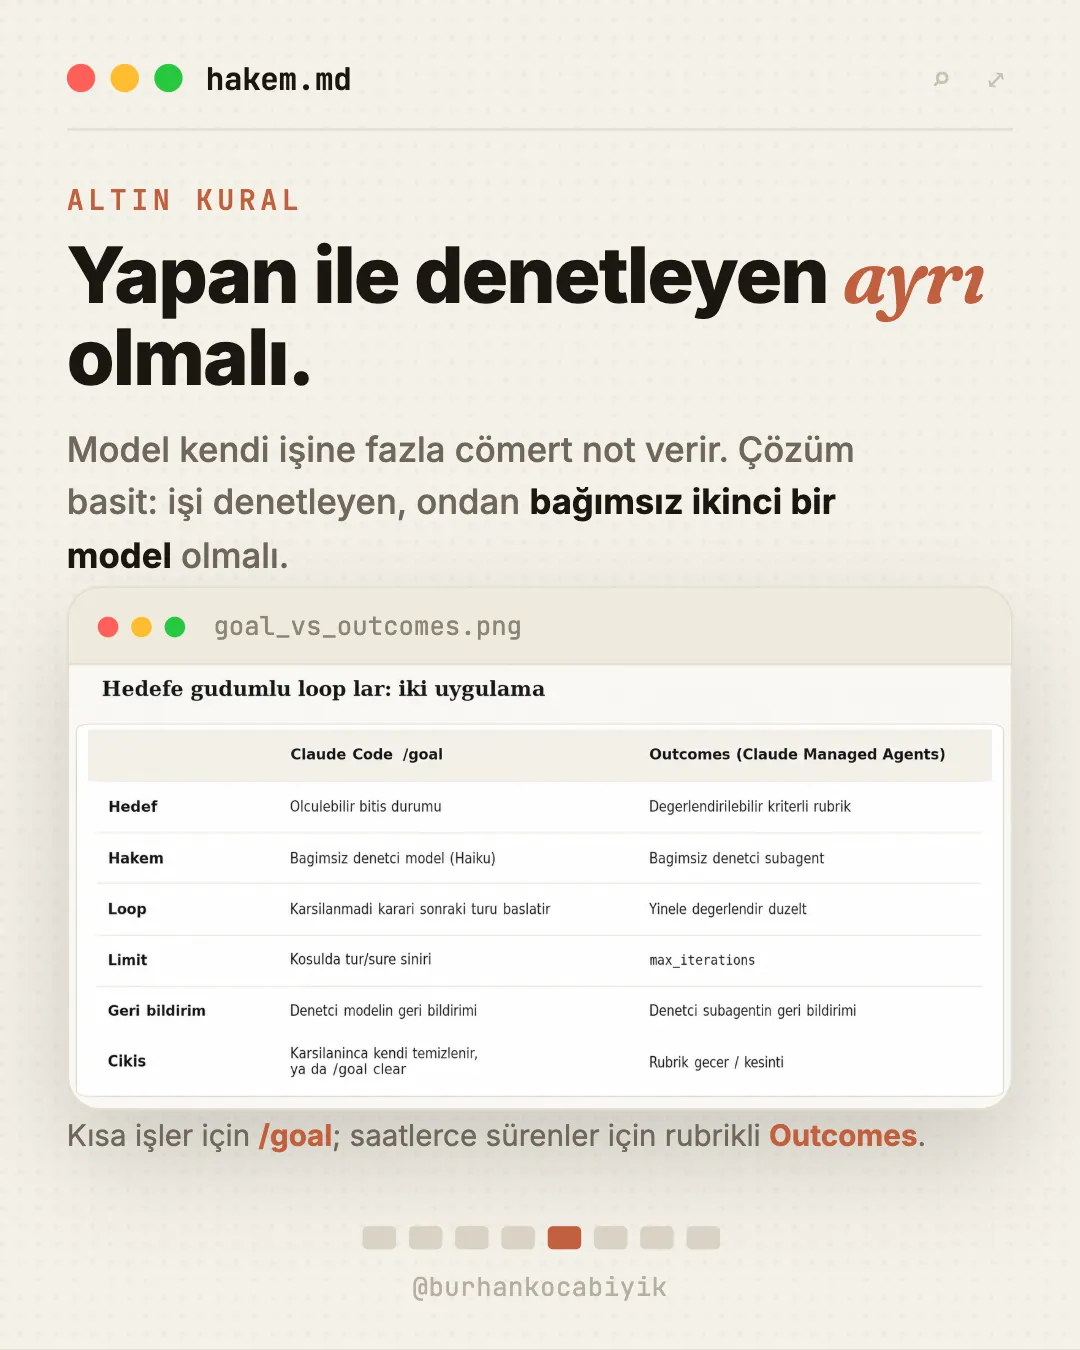
Herkesin atladığı detay bu. Modeller kendi işlerini eleştirmekte kötüdür, kendilerine fazla iyi davranırlar. Kendi sınavını okumak gibi. Anthropic'in çözümü: kendi bağlamı olan, işin kuralı karşılayıp karşılamadığına karar veren bağımsız bir doğrulayıcı subagent. Pratikte iki yolu var:
- Claude Code'da
/goal: ölçülebilir bir koşul tanımlarsın, bağımsız bir model karşılanıp karşılanmadığına karar verir. Karşılanmadıysa bir sonraki turu tek başına başlatır. - Claude Managed Agents'ta
Outcomes: değerlendirilebilir kriterlerden oluşan bir rubrik tanımlarsın, bir subagent her iterasyonda onu denetler.
Parameter Golf'te doğrulayıcı, rubriğin 9 kriteri karşılanana kadar Fable 5'i durdurmadı. Bağımsız hakem olmadan ajan savrulur; bağımsız hakemle ajan iyileşir.
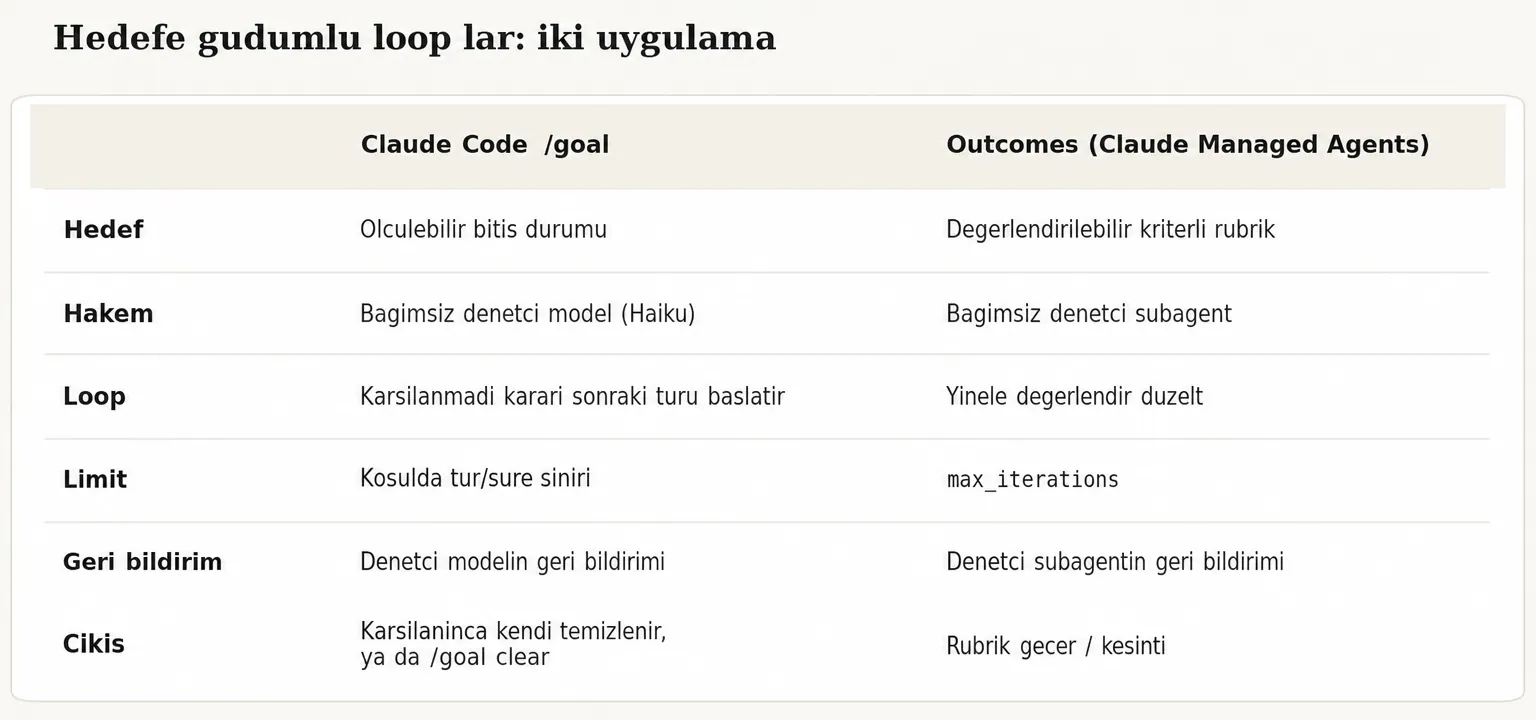
/goal, saatlerce süren işler için rubrikli Outcomes.Hafıza: oturumlar arası yaşayan loop
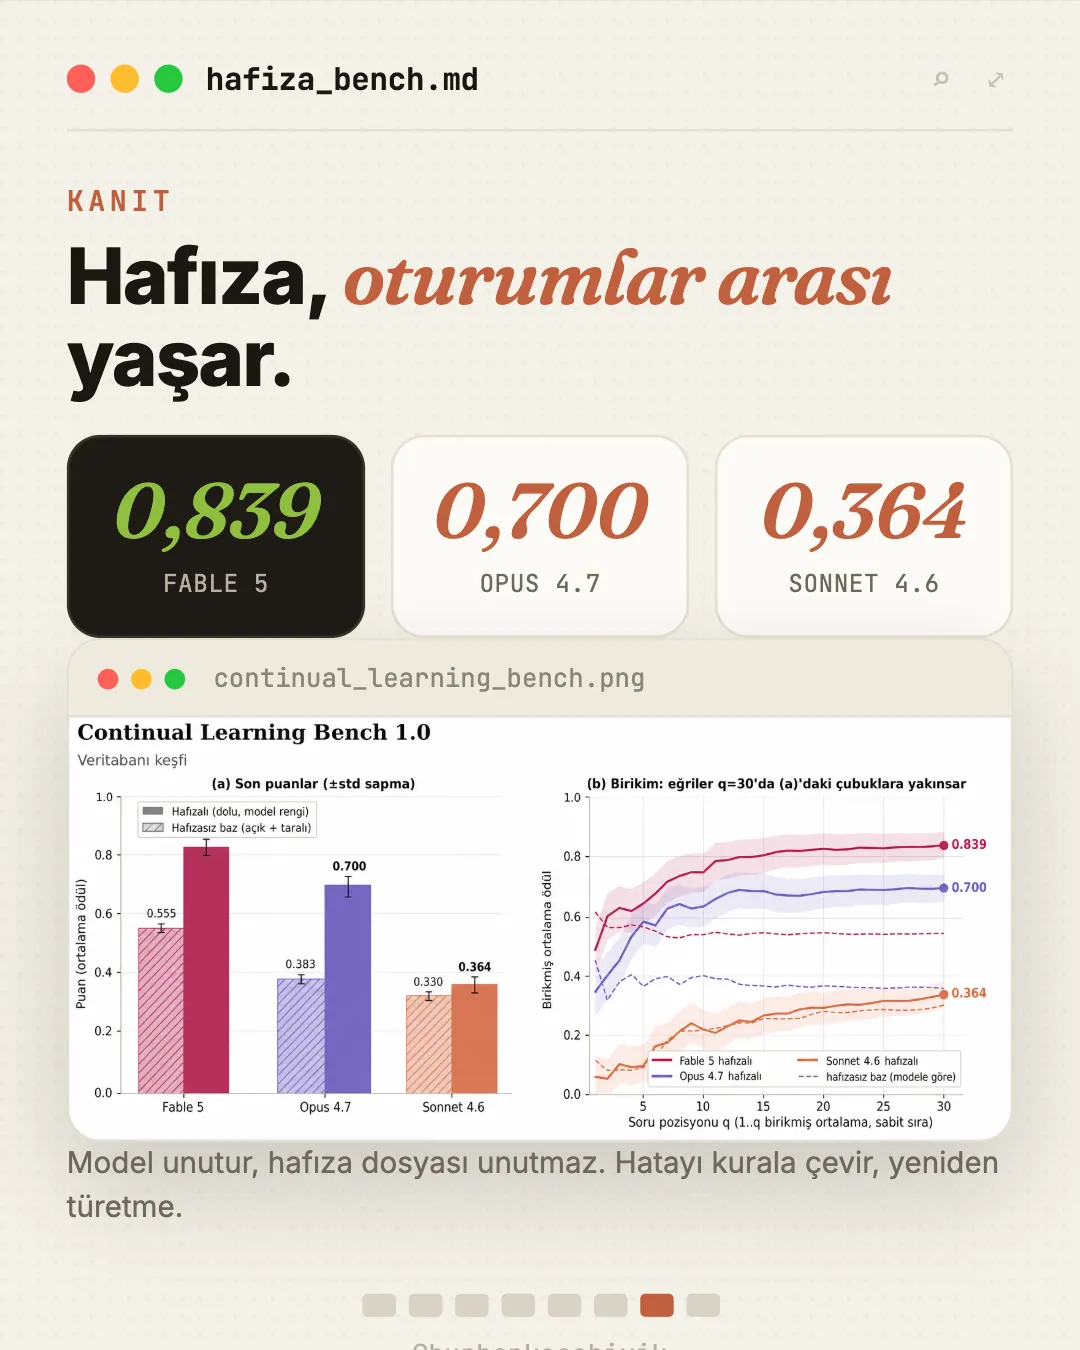
Deneyin ikinci çarpıcı bulgusu: hafıza. Fable 5, Opus 4.7 ve Sonnet 4.6 Continual Learning Bench'te denendi, bir SQL veritabanı üstünde sıralı sorular; her soru yeni bir oturum ama hafıza paylaşılıyor. Sonuçlar:
- Fable 5: 0,839
- Opus 4.7: 0,700
- Sonnet 4.6: 0,364
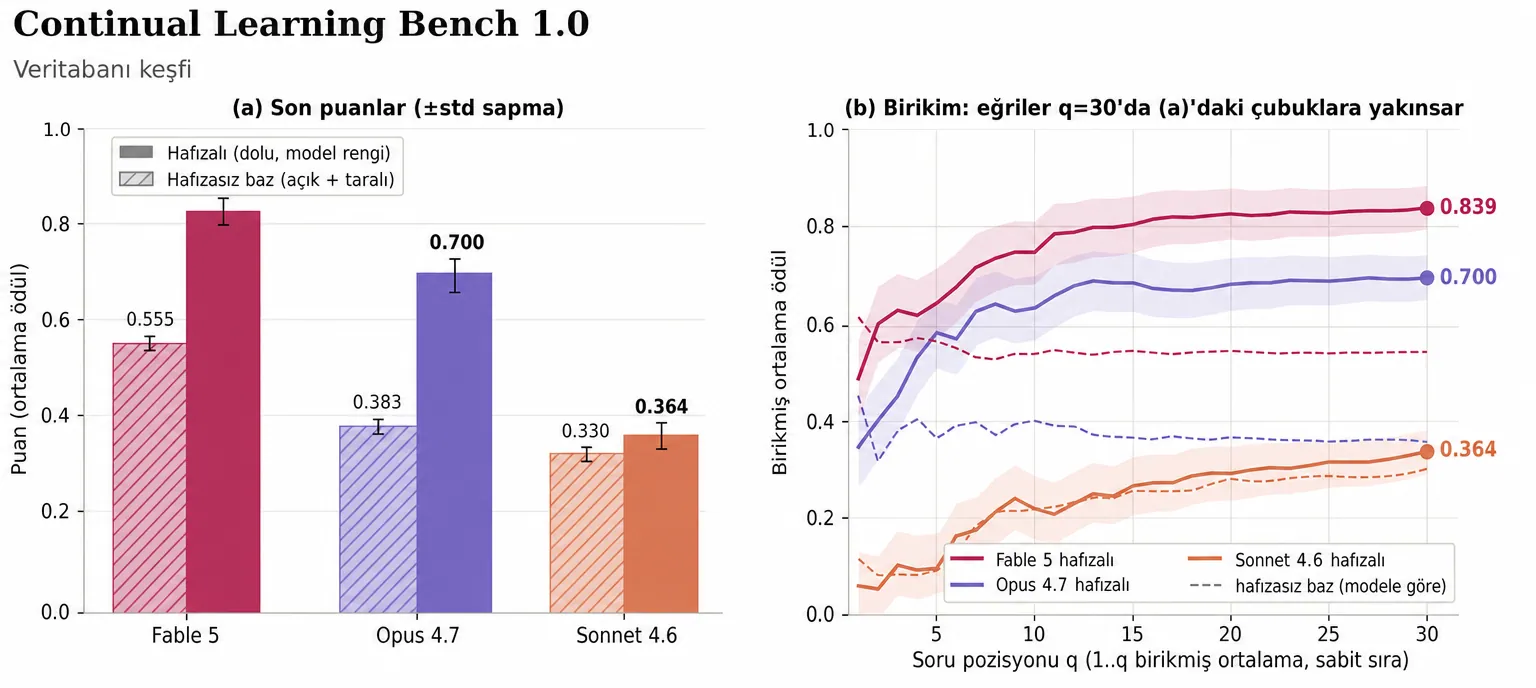
Neden bu kadar fark? Çünkü hafızayı iyi kullanmanın 5 seviyesi var: (1) başarısız ol ve not al, (2) neden başarısız olduğunu araştır, (3) sebebi doğrulayıp gerçeğe çevir, (4) gerçeği genel bir kurala damıt, (5) her seferinde yeniden türetmek yerine kurala başvur. Sonnet 4.6 seviye 1'de kalıyor (not alır ama nadiren okur). Opus 4.7 seviye 3'e ulaşıyor ama yalnızca ~%17 doğruluyor. Fable 5 döngüyü tamamlıyor: teşhislerinin %73'ünü doğruluyor ve gelecekte kullanacağı kurallara çeviriyor.
Açık vs kapalı loop
Kendi loop'unu kurmadan önceki en önemli ayrım:
- Açık loop: geniş bir hedef verip ajanı keşfe bırakırsın. Güçlü ama token'ı acımasızca yakar; net standart yoksa bir "slop makinesine" döner.
- Kapalı loop: yolu sen tasarlarsın, net hedef, tanımlı adımlar, her adımda değerlendirme, durma noktası. Güvenilir, her geçişte iyileşir ve normal bir bütçeye sığar.
Tavsiye: kapalı loop'larla başla. Çalışan kalite kapıların olunca alanı aç.
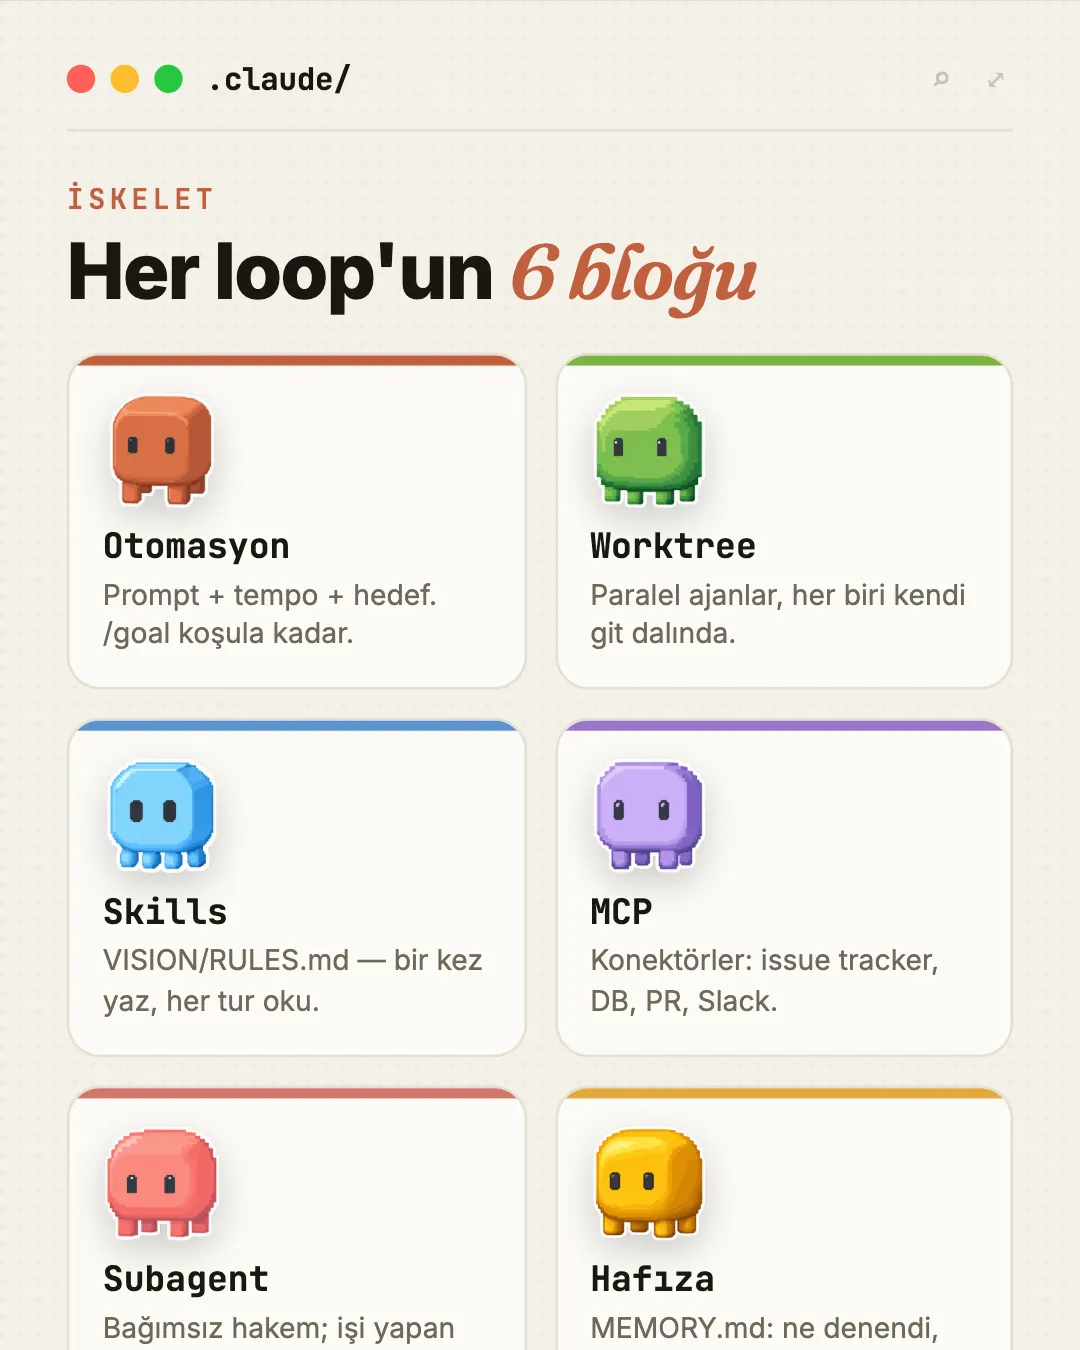
Her iyi loop'un 6 bloğu
Loop'un kalbi
Bir prompt + bir tempo + bir hedef. /goal koşul doğru olana kadar devam eder; sen gidersin.
Paralel ajanlar
Her ajan kendi git dalında, kendi izole dizininde. Birbirlerine basmadan paralel çalışırlar.
Proje bilgisi
VISION.md, ARCHITECTURE.md, RULES.md. Bir kez yaz, her çevrimde oku. Yoksa loop projeni her tur sıfırdan türetir.
Konektörler
Sadece dosya sistemini gören loop küçüktür. Konektörlerle issue tracker'ı okur, veritabanını sorgular, PR açar, Slack'e haber verir.
Bağımsız hakem
Doğrulayan, işi yapan asla olmaz. Taze bir model loop'un bitip bitmediğine karar verir.
Konuşma dışı bellek
Basit bir markdown: ne denendi, ne oldu, ne açık. 47. günün loop'u 1-46. günleri bilir.
İlk loop'unu kur (adım adım)
İki resmî yol var. Kolaydan başlayalım.
Seçenek A: Claude Code'da /goal
1. "Bitti" ne demek tanımla. Hedef bir görüş değil, doğrulanabilir olmalı. Kötü: "kimlik doğrulama kodunu iyileştir". İyi: "tests/auth testlerinin hepsi geçsin ve lint temiz olsun". Bir komutla kontrol edemiyorsan, o bir hedef değil; bir dilek.
2. Ajana bağlam ver. Repona şu dosyaları koy: VISION.md (başarı neye benziyor), ARCHITECTURE.md (stack ve klasör yapısı), RULES.md (ajanın asla dokunamayacağı şeyler). Beş dakika; karşılığında loop projeni her turda sıfırdan türetmez.
3. Loop'u başlat.
/goal tests/auth testlerinin hepsi geçiyor ve lint temiz. En fazla 30 tur.Son cümleye dikkat: koşulun içine her zaman bir tur ya da süre sınırı koy. Bu senin acil frenin.
4. Sistemin çalışmasına izin ver. Buradan sonrası otomatik: ajan hedefe doğru çalışır → bağımsız bir model (işi yapan değil) koşulun karşılanıp karşılanmadığını değerlendirir → "karşılanmadı" ise bir sonraki tur kendiliğinden başlar → "karşılandı" ise hedef otomatik temizlenir ve loop durur. Yeşile dönünce gelirsin; erken kesmek istersen /goal clear.
Seçenek B: rubrik + Outcomes (Claude Managed Agents)
Saatler süren uzun görevler için CMA, sana barındırılan harness ve sandbox veriyor. Burada koşul yerine bir rubrik yazıyorsun: satır başına bir değerlendirilebilir kriter. max_iterations sınırını ayarlıyorsun ve Outcomes her turda rubriği denetleyen bir düzeltici subagent çalıştırıyor. Ajan her şey geçene kadar duramıyor, Fable 5 işte böyle 8 saat tek başına koştu.
Loop günlerce koşacaksa bir MEMORY.md oluştur: DENENEN (deneyler + sonuç), DOĞRULANAN (kanıtlanmış gerçekler), AÇIK (denenecekler). RULES.md'ye bir kural ekle: "başlamadan önce MEMORY.md'yi oku, bitirmeden önce güncelle." Fable 5'in en iyi yaptığı şey tam olarak bu: hataları doğrulanmış kurallara çevirip yeniden türetmek yerine onlara başvurmak.
4 gerçek loop
- Kod loop'u: bağlamı oku → değişikliği planla → düzenle → testleri çalıştır → geçmezse hatayı oku ve düzelt → geçerse özetle ve dur. İnsan ortada yok.
- Araştırma loop'u: soruyu tanımla → kaynak bul → özetle → iddiaları kaynaklara karşı doğrula → çelişkileri karşılaştır → sentezle → güven eşiği aşılınca dur.
- İçerik loop'u: konu + kitle + hedef → taslak → eleştirmen ajan inceler → yeniden yaz → başarı kriterlerine karşı puanla → geçerse yayınla, geçmezse bir tur daha.
- Satış loop'u: ideal müşteri profili → lead bul → veriyle zenginleştir → nitele → mesajı kişiselleştir → kalite kontrolü → gönder ya da bir insana yükselt.
Hepsinin iskeleti aynı: Hedef → Aksiyon → Doğrulama → Düzeltme → Bitene kadar tekrarla.
Prompt engineer vs loop engineer
2026'da açılan beceri farkı: prompt engineer daha iyi talimat yazar, her çıktıyı elle inceler, feedback loop kendisidir. Loop engineer ise daha iyi geri bildirim çevrimleri tasarlar, testler otomatik inceler, sistem feedback loop'tur. Biri "bana bir fonksiyon yaz" der; öteki "yaz → test et → yeşile dönene kadar düzelt" diye tasarlar. Araçlar aynı, zihniyet bambaşka.
Son söz: kimsenin yüksek sesle söylemediği nüans
İki kişi tıpatıp aynı loop'u kurup zıt sonuçlar alabilir. Biri onu derinlemesine anladığı bir işte daha hızlı gitmek için kullanır; öteki işi hiç anlamamak için. Loop farkı bilmez, sen bilirsin. Loop'larını, hâlâ mühendis kalmayı düşünen biri gibi tasarla, sadece düğmeye basan biri gibi değil. Çünkü güvenilir bir loop, bin mükemmel prompt'tan değerli.
Sıkça sorulan sorular
"Doğrulanabilir hedef" tam olarak ne demek?
Bir komutla pass/fail olarak kontrol edebildiğin bir koşul. "Kodu iyileştir" doğrulanabilir değil; "tests/auth geçsin ve lint temiz olsun" doğrulanabilir. Komutla ölçemiyorsan, o bir hedef değil, dilektir.
Neden işi yapan ajan kendini değerlendiremiyor?
Modeller kendi işlerine fazla iyi not verir, kendi sınavını okumak gibi. Bu yüzden kendi bağlamı olan bağımsız bir doğrulayıcı (subagent) şart. Bağımsız hakem olmadan ajan savrulur.
Açık mı kapalı loop'la mı başlamalıyım?
Kapalı. Net hedef, tanımlı adımlar, her adımda değerlendirme, durma noktası. Güvenilir ve bütçe dostu. Çalışan kalite kapıların olunca açık loop'a (daha geniş keşif) geçersin.
Loop sonsuza kadar koşmaz mı?
Koşmasın diye koşulun içine her zaman bir tur/süre sınırı koyuyorsun (örn. "en fazla 30 tur"). Bu acil fren. Hedef karşılanınca da kendiliğinden temizlenip duruyor; /goal clear ile elle de kesebilirsin.
Hafızayı nasıl kuruyorum?
Konuşma dışında basit bir MEMORY.md: DENENEN / DOĞRULANAN / AÇIK bölümleri. RULES.md'ye "başta oku, sonda güncelle" kuralını ekle. Böylece ajan her gün sıfırdan başlamaz, bilgi biriktirir.
- Artık iyi prompt yazmak yetmiyor; iyi döngü kurmak gerekiyor.
- Tek seferlik komut yerine, kendi kendini besleyen ajan döngüleri kuruyorsun.
- Ajan bir işi yapıyor, sonucu kontrol ediyor, hatasını düzeltip tekrar deniyor.
- Sen her adımı yönetmiyorsun; sadece hedefi ve sınırları veriyorsun.
- Yani prompt mühendisliğinden sistem mühendisliğine geçiyoruz.
KAYDIRMALI Bu yazının Instagram versiyonu
Aynı içeriğin kaydırmalı (carousel) hali, kaydet, paylaş, kullan.
5 maddede özet
- Prompt değil loop: ajana talimat değil, doğrulanabilir bir iş ver; keşfet → planla → uygula → doğrula → yinele.
- Doğrulanabilir hedef: "güzel yap" değil, "testler geçsin, lint temiz". Komutla ölçülemiyorsa hedef değil.
- Yapan ≠ yargılayan: bağımsız doğrulayıcı subagent şart. Claude Code'da
/goal, CMA'daOutcomes. - Hafıza kazandırır: Continual Learning Bench'te Fable 5 0,839 vs Sonnet 4.6 0,364. Hatayı kurala çevir, yeniden türetme.
- Kapalıdan başla, sınır koy: tur/süre limiti acil fren; çalışınca alanı aç. Güvenilir loop > bin prompt.