GPT'nin sırrı mimaride değil: sıfırdan kendi modelin
GPT, Claude ve Gemini'nin hepsinin çıktığı 5 aşamalı boru hattı ve bu gece laptopunda küçük bir modeli nasıl eğitebileceğin, adım adım.
LLM'leri özel kılan şey mimari değil, transformer herkese açık, herkes aynısını kullanıyor. GPT, Claude, Gemini ve Llama hepsi aynı 5 aşamalı boru hattından çıkıyor: veri, tokenizasyon, eğitim, hizalama, değerlendirme. Asıl sır verinin nasıl temizlendiğinde ve modelin nasıl hizalandığında saklı. PhD gerekmiyor, kod dahil; bir GPT-4 klonu değil ama gerçek, çalışan bir dil modeli bu gece laptopunda eğitilebilir. Aşağıda her aşama, projeleri batıran beş hata ve başlangıç kurulumu tek tek var.
Hızlı not: Çoğu kişi bunu "ulaşılmaz bir bilim" sanıyor. Oysa zor olan kısım matematik değil, mühendislik. Aşağıda anlatılan her şey gerçek; bir akşamda mini bir modelin perplexity'si 800'den 50'ye kadar inebiliyor.
Herkesin inandığı yalan: mesele mimari değil
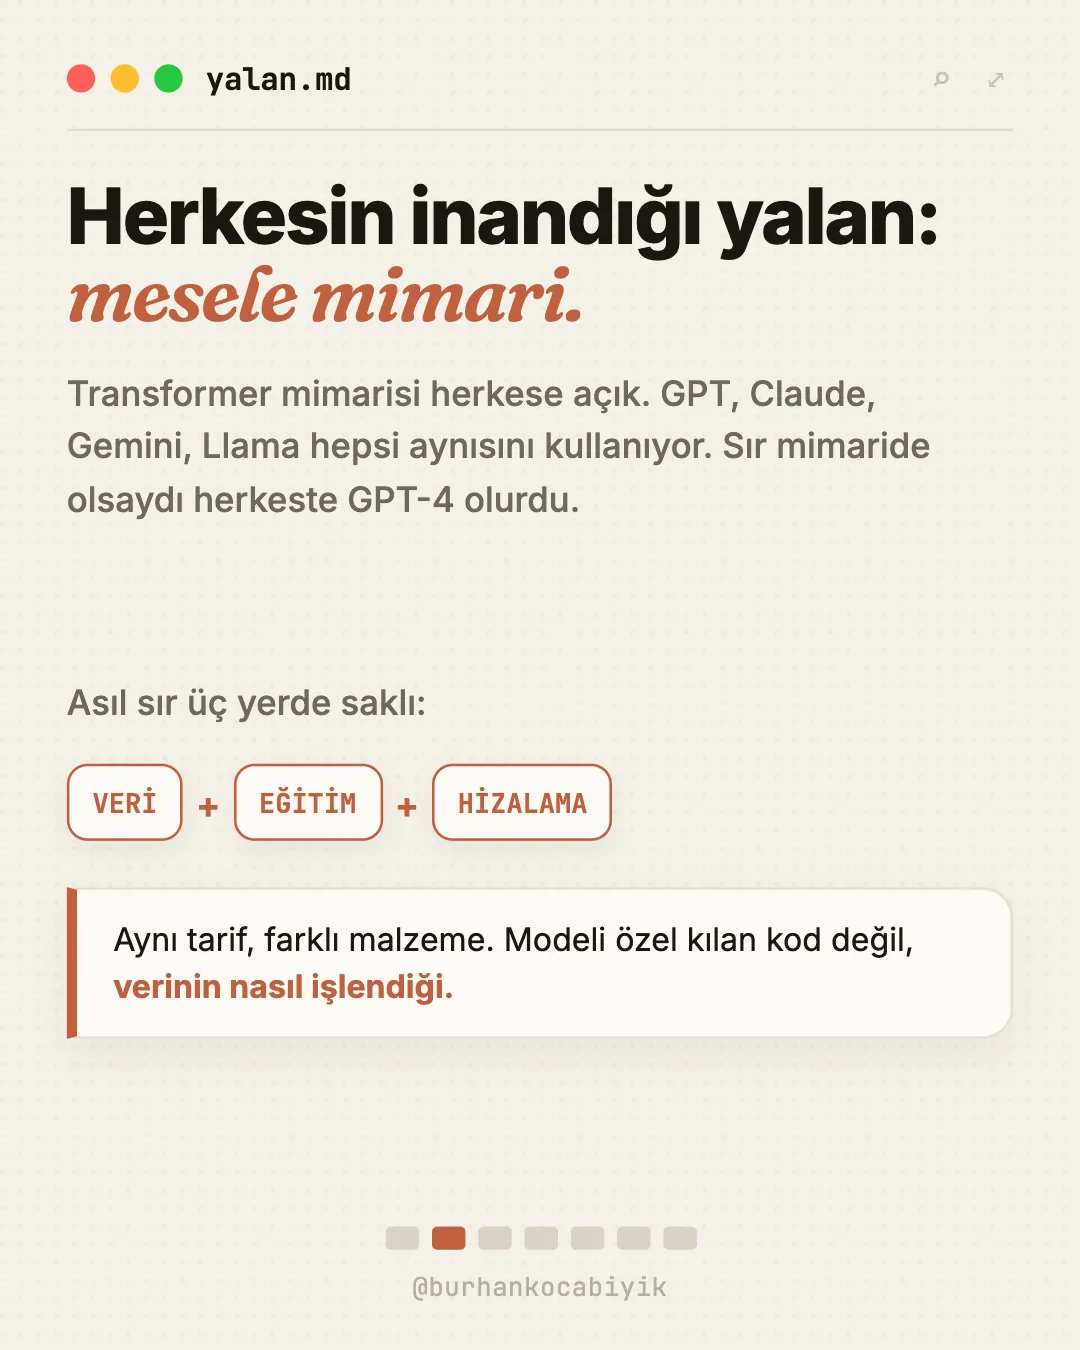
İnsanların çoğu bir modeli güçlü yapanın gizli bir mimari olduğunu sanıyor. Oysa transformer mimarisi tamamen açık. GPT, Claude, Gemini, Llama, hepsi aynı temel yapıyı kullanıyor. Bu yapı herkese açık bir bilgi.
Eğer sır mimaride olsaydı, mimariyi okuyan herkesin elinde bir GPT-4 olurdu. Olmuyor. Çünkü farkı yaratan şey kod değil. Asıl sır üç yerde saklı: veri, eğitim ve hizalama. Aynı tarif herkeste var; farkı malzemenin kalitesi ve nasıl işlendiği yaratıyor.
5 aşamalı boru hattı
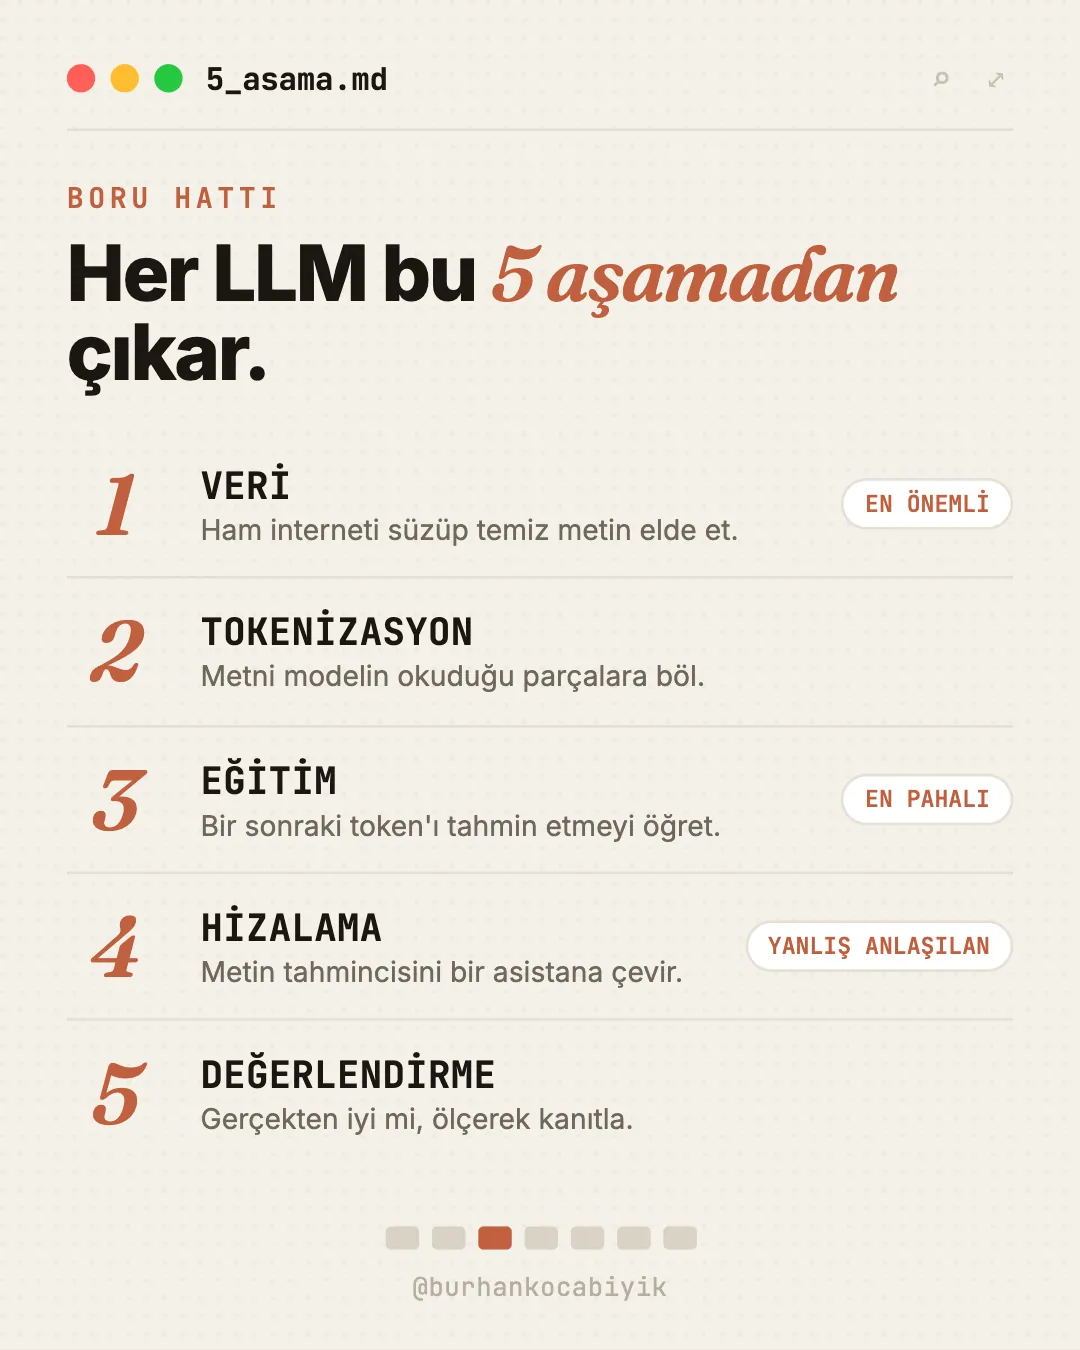
Hangi şirketin modeli olursa olsun, üretim hep aynı beş aşamadan geçiyor. Sıra da önemli, çünkü her aşama bir öncekinin çıktısına dayanıyor.
1. Veri
Ham interneti süzüp temiz, kaliteli metin elde etme. Tüm modelin temeli burada.
2. Tokenizasyon
Metni modelin okuyabileceği küçük parçalara bölme.
3. Eğitim
Modele bir sonraki token'ı tahmin etmeyi öğretme.
4. Hizalama
Metin tahmincisini sohbet edebilen bir asistana çevirme.
Aşama 1, Veri: en önemli ve en korunan sır
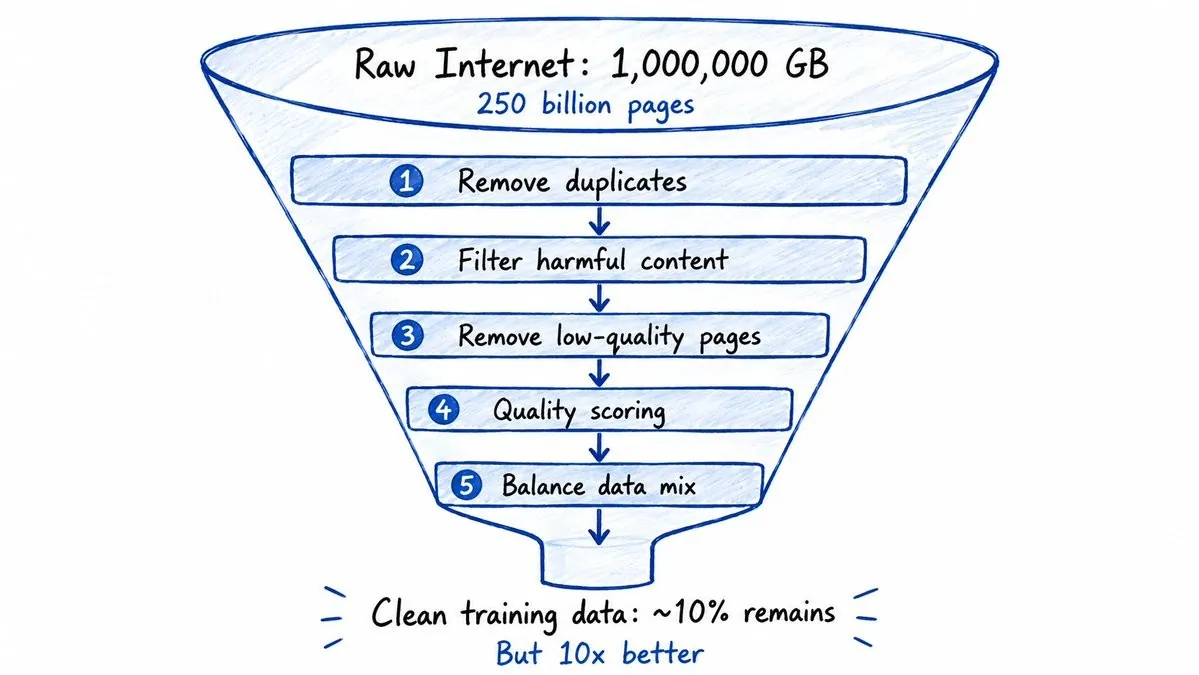
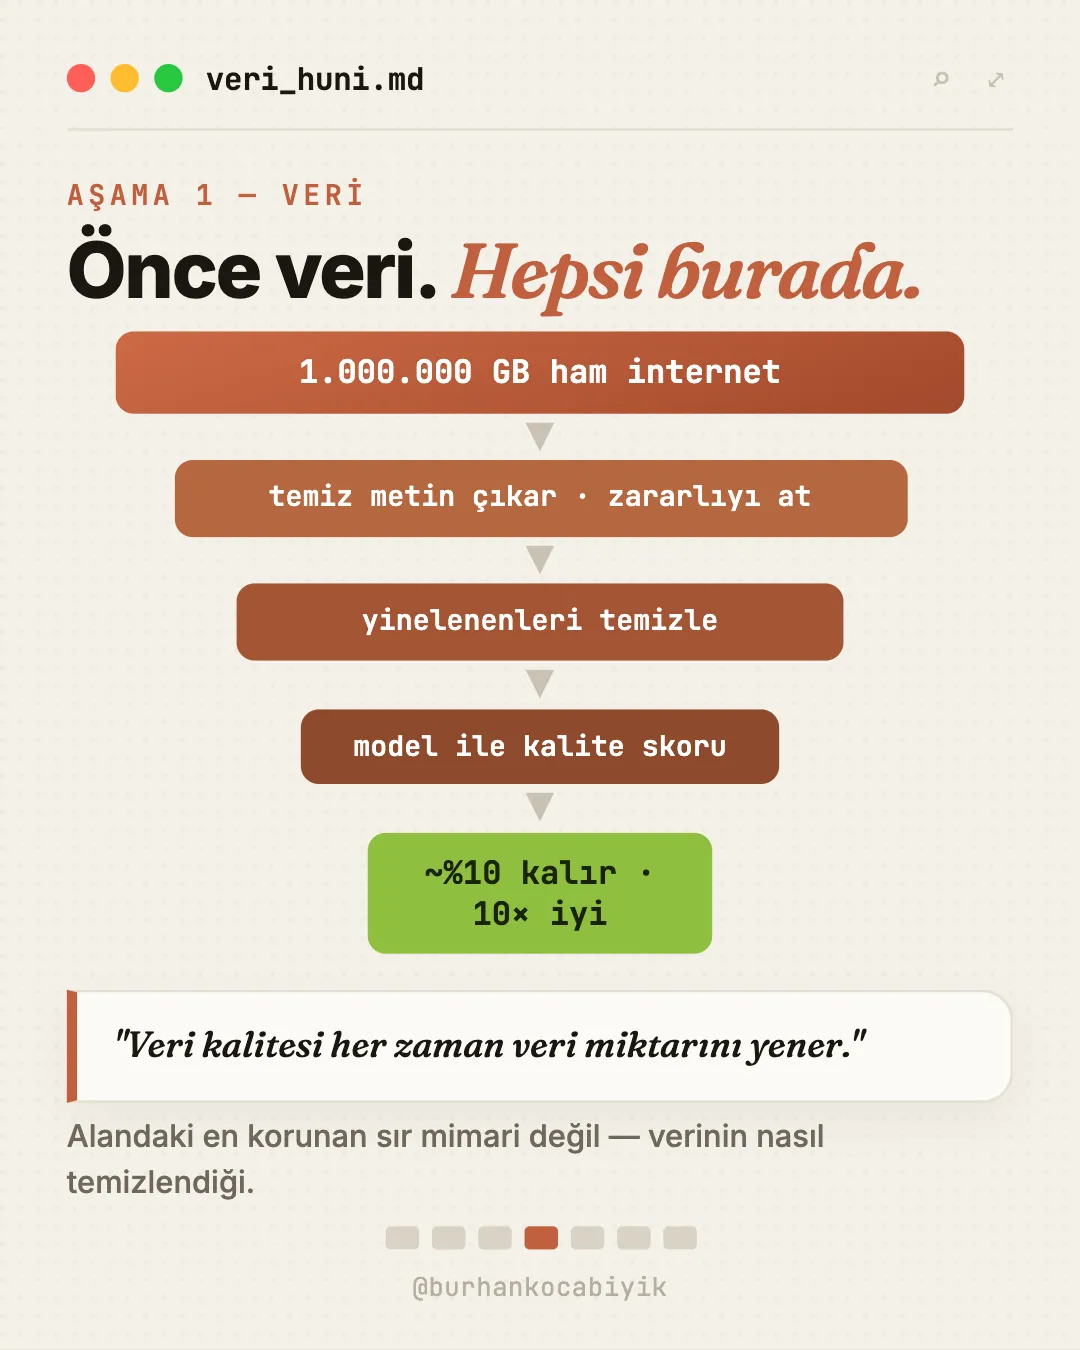
Ham internet inanılmaz büyük. Common Crawl'da yaklaşık 250 milyar sayfa, kabaca 1.000.000 GB veri var. Ama bu verinin çoğu çöp: spam, tekrar, anlamsız metin. Olduğu gibi kullanırsan kötü bir model elde edersin.
Bu yüzden veriyi çok adımlı bir filtreden geçiriyorsun:
- HTML'den temiz metni çıkar.
- Zararlı ve kişisel veriyi at.
- Yinelenen içerikleri temizle.
- Düşük kaliteli metni ele.
- Model tabanlı bir kalite skoru ver: "Bir Wikipedia editörü bunu kaynak olarak gösterir miydi?"
- Kod, kitap, bilim ve web içeriğini dengele.
Bu süreçten sonra elinde ham verinin yaklaşık %10'u kalıyor, ama bu kalan kısım 10 kat daha iyi. İşte alandaki en korunan sır mimari değil, verinin tam olarak nasıl temizlendiği.
Veri kalitesi her zaman veri miktarını yener.LLM eğitiminin birinci kuralı
Aşama 2, Tokenizasyon: model kelime değil, token okur
Model metni kelime kelime okumuyor; "token" denen parçalara bölüp öyle okuyor. Örneğin "playing" kelimesi "play" ve "ing" olarak ikiye ayrılabiliyor.
Bunu yapan yöntemin adı Byte-Pair Encoding (BPE). Sık geçen karakter çiftlerini birleştire birleştire 32.000 ila 100.000 token'lık bir sözlük oluşturuyor. Kaba bir çevirme tablosu şöyle:
- 1 token ≈ 0,75 kelime
- 1.000 token ≈ 750 kelime
- 100 bin token ≈ bir roman
Aşama 3, Eğitim: tek bir basit hedef
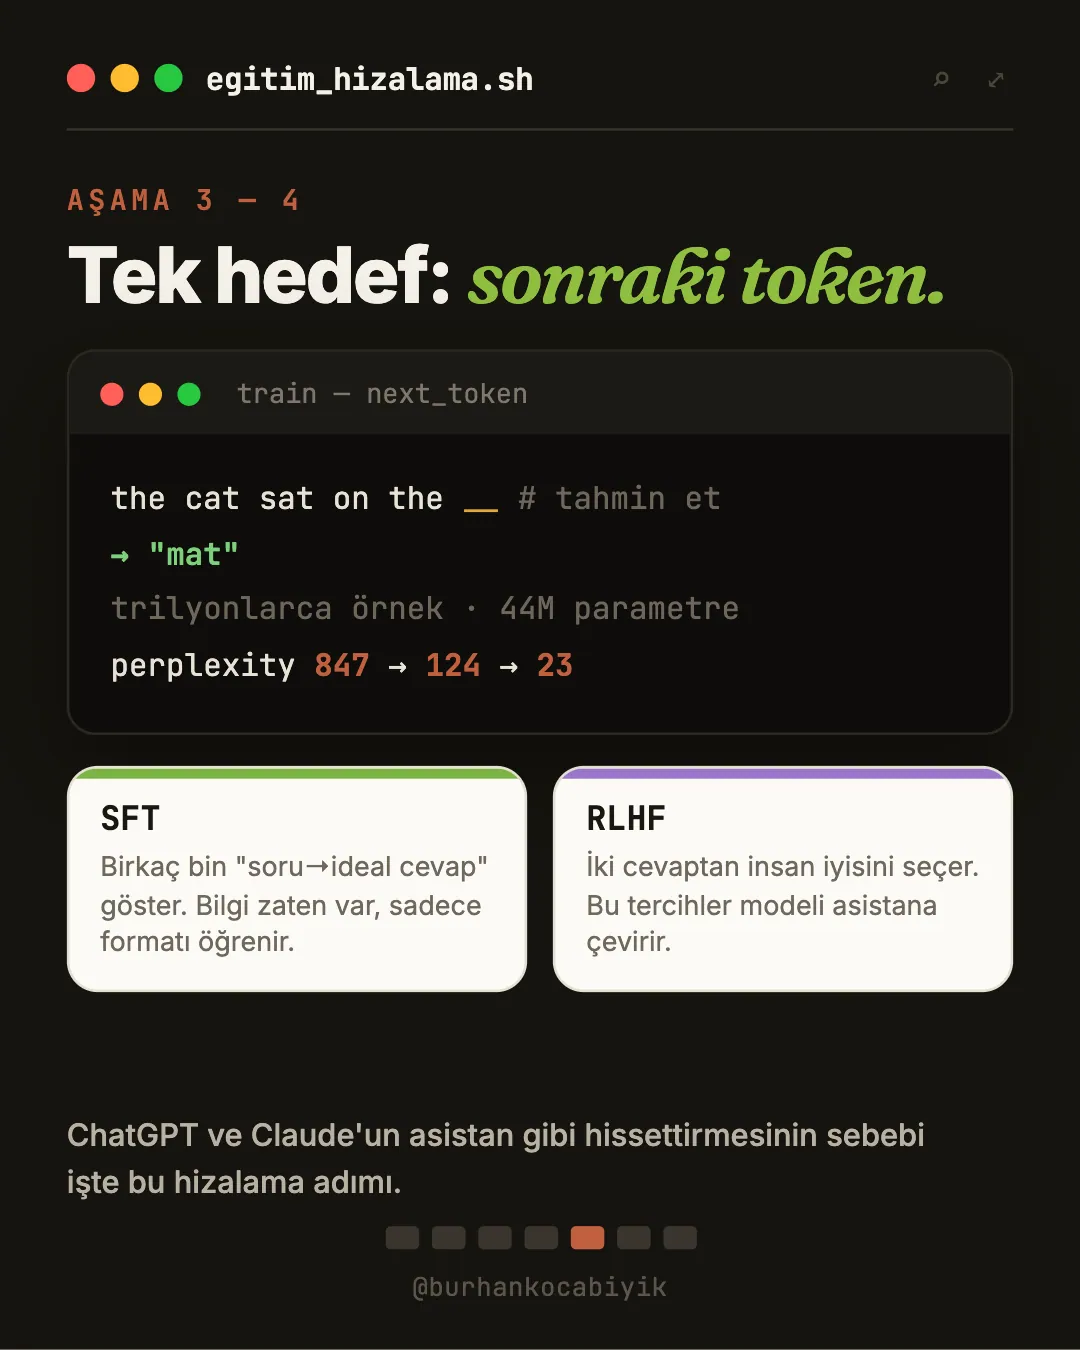
Eğitimin hedefi kulağa çok basit geliyor: bir sonraki token'ı tahmin et. "The cat sat on the __" cümlesini verip "mat" demesini istiyorsun. Hepsi bu.
Ama bunu trilyonlarca örnek üzerinde yapınca sihirli bir şey oluyor: dilbilgisi, gerçek bilgiler, akıl yürütme ve hatta kod yazma yeteneği kendiliğinden ortaya çıkıyor. Kimse modele bunları tek tek öğretmiyor; sadece tahmin yaparak öğreniyor.
Kavramı somutlaştırması için minik bir eğitim döngüsü şöyle görünür:
# minik, kavramsal bir eğitim adımı
for batch in veri:
    girdi  = batch[:, :-1]        # "the cat sat on the"
    hedef  = batch[:, 1:]         # "cat sat on the mat"
    tahmin = model(girdi)         # bir sonraki token tahmini
    loss   = capraz_entropi(tahmin, hedef)
    loss.backward()              # hatayı geriye yay
    optimizer.step()            # ağırlıkları güncelle
# loss düştükçe model daha iyi tahmin eder
Örnek olarak küçük bir model 44 milyon parametreden oluşabilir (embedding boyutu 512, 8 dikkat başlığı, 6 katman). Eğitim sırasında tek baktığın şey "loss" değeri: düşük loss, daha iyi tahmin demek.
Aşama 4, Hizalama: metin tahmincisini asistana çevirmek
Bu aşama en çok yanlış anlaşılan kısım. Eğitim biten model akıcı metin üretir ama sohbet etmeyi bilmez; sorduğun soruyu cevaplamak yerine devam ettirir. Onu bir asistana çevirmek için iki adım var.
SFT (denetimli ince ayar): Modele birkaç bin "soru → ideal cevap" örneği gösteriyorsun. Bilgi zaten içinde var; bu adımda sadece formatı öğreniyor. Yani "sorulduğunda cevap ver" davranışını kazanıyor.
RLHF (insan geri bildiriminden öğrenme): Model bir soruya iki farklı cevap üretiyor, bir insan hangisinin daha iyi olduğunu seçiyor. Bu tercihlerle bir "ödül modeli" eğitiliyor ve asıl model bu ödülü en yükseğe çıkaracak şekilde ayarlanıyor. ChatGPT ve Claude'un asistan gibi hissettirmesinin sebebi tam olarak bu adım.
Aşama 5, Değerlendirme: gerçekten iyi mi?
Eğitim sırasında perplexity değerine bakıyorsun. Perplexity, modelin gerçek metin karşısında ne kadar "şaşırdığını" ölçüyor; düşük olması iyi. Tipik bir eğitimde bu değer 847'den 124'e, oradan 23'e iniyor.
Ama hizalamadan sonra perplexity artık işe yaramıyor, çünkü model artık ham metin tahmin etmiyor. O aşamada insan odaklı ölçütlere geçiyorsun:
- MMLU: 57 farklı konuda çoktan seçmeli sınav.
- Chatbot Arena: İnsanlar iki cevabı kör olarak karşılaştırıp oy veriyor.
- AlpacaEval: Bir LLM, başka bir LLM'i yargılıyor; tahmini maliyeti yaklaşık $10.
Önemli olan şu: tek bir skor iyi bir modeli yakalayamaz. Birden fazla ölçütü birlikte okuman gerekiyor.
Üretim aşamasında "temperature" ayarıyla çıktının karakterini belirliyorsun: 0,1 güvenli ve tekrarlı, 0,8 doğal, 1,5 ise yaratıcı ama dağınık.
Projeleri batıran 5 hata
Bu yolda sık görülen ve modeli baştan mahkûm eden beş hata var:
- Mimariye takılmak: Herkes aynı mimariyi kullanıyor; orada saatler harcamak boşa.
- Veriyi önemsememek: En önemli aşamayı ezgeçmek, kötü bir modelin garantisi.
- Ölçek matematiğini atlamak: Kaba kural, her parametre için yaklaşık 20 token veri.
- SFT'de durup RLHF yapmamak: Model asistan gibi hissettirmiyorsa sebebi genelde bu.
- Hizalamadan sonra perplexity'ye güvenmek: O noktada perplexity yanıltıcı olur.
Harika bir LLM eğitilmez, mühendislik edilir.Bu işin özeti tek cümlede
Başlangıç kurulumu: bu gece dene
Teoriyi okumak yeter; en hızlı öğrenme yolu küçük bir model eğitmek. Şununla başla:
pip install torch tokenizers datasetsVeri olarak WikiText'i kullan, yaklaşık 15 milyon parametrelik mini bir model kur. Laptop GPU'nda ya da ücretsiz Google Colab'da saatler içinde eğitebilirsin. Tek yapman gereken perplexity'nin 800'lerden 50'lere düşmesini izlemek. O an her şey yerine oturuyor.
Niş LLM fikirleri: veriyi değiştir, uzmanı değiştir
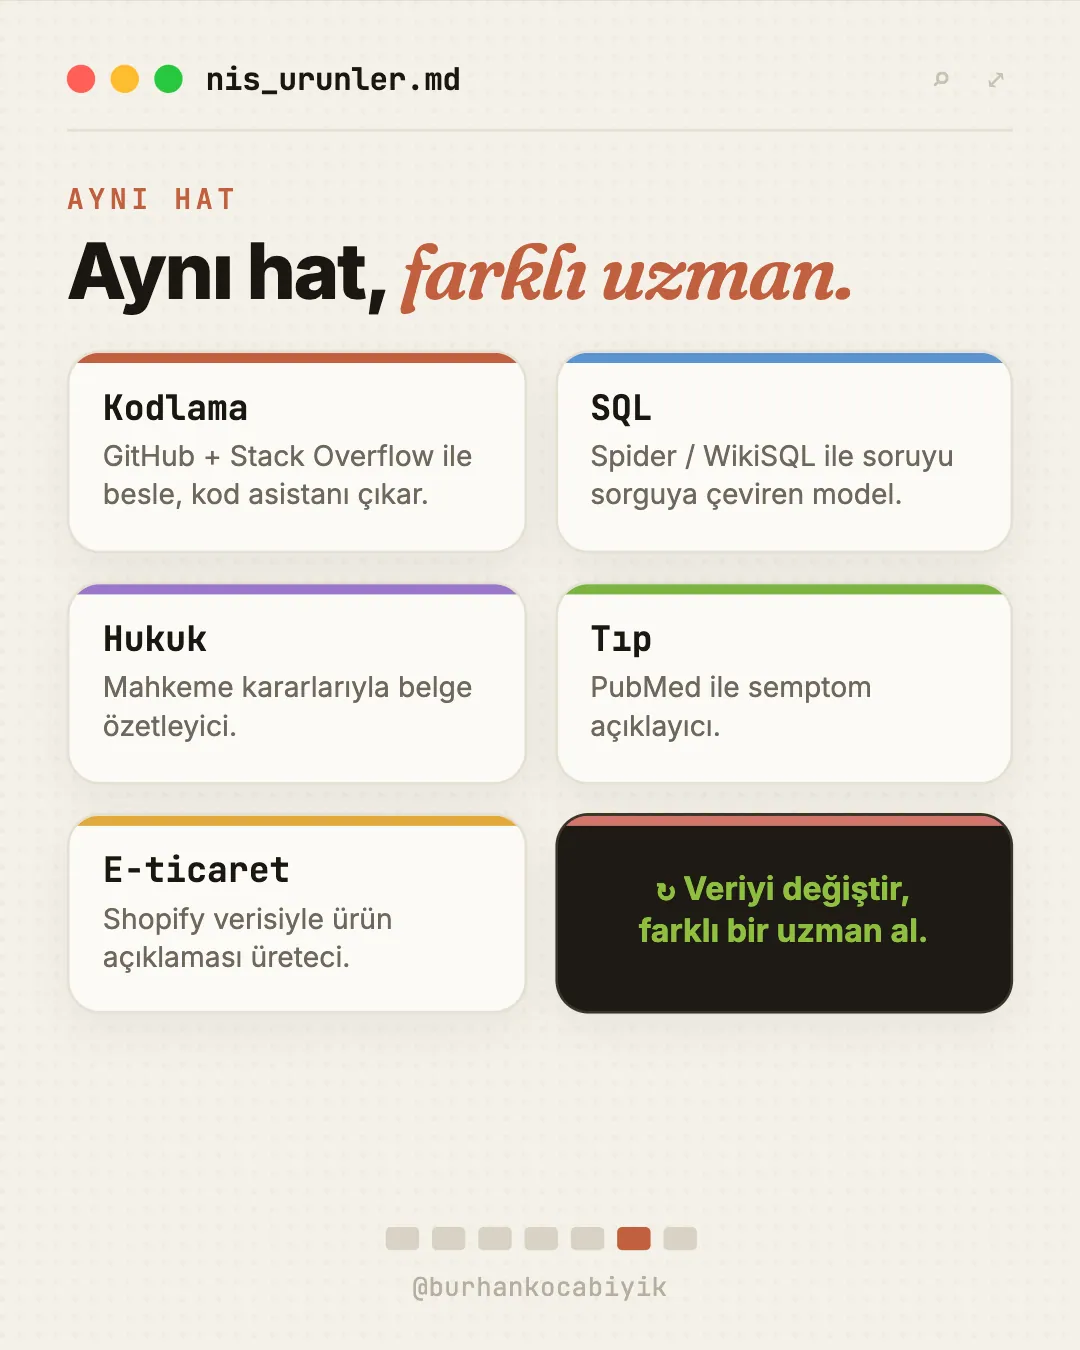
İşin güzel yanı şu: boru hattı hep aynı, sadece veriyi değiştiriyorsun. Aynı süreçle çok farklı uzmanlar elde edebilirsin:
- Kodlama asistanı, GitHub + Stack Overflow verisiyle.
- SQL üreteci, Spider / WikiSQL verisiyle, soruyu sorguya çevirir.
- Hukuki belge özetleyici, mahkeme kararlarıyla.
- Tıbbi semptom açıklayıcı, PubMed verisiyle.
- E-ticaret ürün açıklaması üreteci, Shopify verisiyle.
Veriyi değiştir, farklı bir uzman al. Mimari hep aynı kalır.
Sıkça sorulan sorular
Gerçekten PhD gerekmiyor mu?
Hayır. Zor olan kısım ileri matematik değil, mühendislik. PyTorch ve hazır veri setleriyle mini bir model eğitmek bir akşamlık iş; akademik bir geçmiş şart değil.
Sonunda GPT-4 gibi bir model mi çıkıyor?
Hayır. Bu mini bir model. Amaç bir GPT-4 klonu üretmek değil; boru hattını gerçekten anlamak ve çalışan, küçük ama gerçek bir dil modeli kurmak.
Ne kadar donanım lazım?
Laptop GPU'su ya da ücretsiz Google Colab yeterli. 15 milyon parametrelik bir model saatler içinde eğitilebiliyor; pahalı bir sunucuya gerek yok.
En kritik aşama hangisi?
Veri. Mimari herkeste aynı; farkı verinin nasıl temizlendiği ve dengelendiği yaratıyor. O yüzden zamanın çoğu veriye gitmeli.
Bunu bir işe nasıl çeviririm?
Boru hattı sabit, sadece veriyi değiştirirsin. Hukuk, SQL, tıp ya da e-ticaret gibi tek bir niş için uzmanlaşmış küçük bir model eğitip onu bir ürüne dönüştürebilirsin.
- GPT ve Claude'un sırrı sandığın gibi mimaride değil.
- Çünkü transformer mimarisi herkese açık; fark verinin nasıl işlendiğinde.
- Her model aynı 5 aşamadan çıkıyor: veri, token, eğitim, hizalama, değerlendirme.
- En önemli aşama veri; çünkü veri kalitesi her zaman miktarı yener.
- En güzeli: PhD gerekmiyor, bu gece kendi küçük modelini eğitebilirsin.
KAYDIRMALI Bu yazının Instagram versiyonu
Aynı içeriğin kaydırmalı (carousel) hali, kaydet, paylaş, kullan.
5 maddede özet
- Sır mimaride değil: transformer herkese açık. Farkı veri, eğitim ve hizalama yaratıyor.
- Veri en önemli aşama; ham internetin yaklaşık %10'u kalır ama 10 kat daha iyi olur.
- Eğitimin tek hedefi "bir sonraki token'ı tahmin et"; gerisi kendiliğinden ortaya çıkar.
- Modeli asistan yapan şey hizalama: SFT formatı, RLHF ise insan tercihini öğretir.
- Bu gece torch + WikiText ile mini bir model eğitip perplexity'nin düşüşünü izleyebilirsin.