Stanford ve Berkeley'nin yazdığı sistem: açık modeli gerçek bir işe çevirmek
Beş ilke: akışı programla, doğrulayıcı kur, role göre parçala, uzmanlığı skill'e yaz, modeli gerçek veriye bağla.
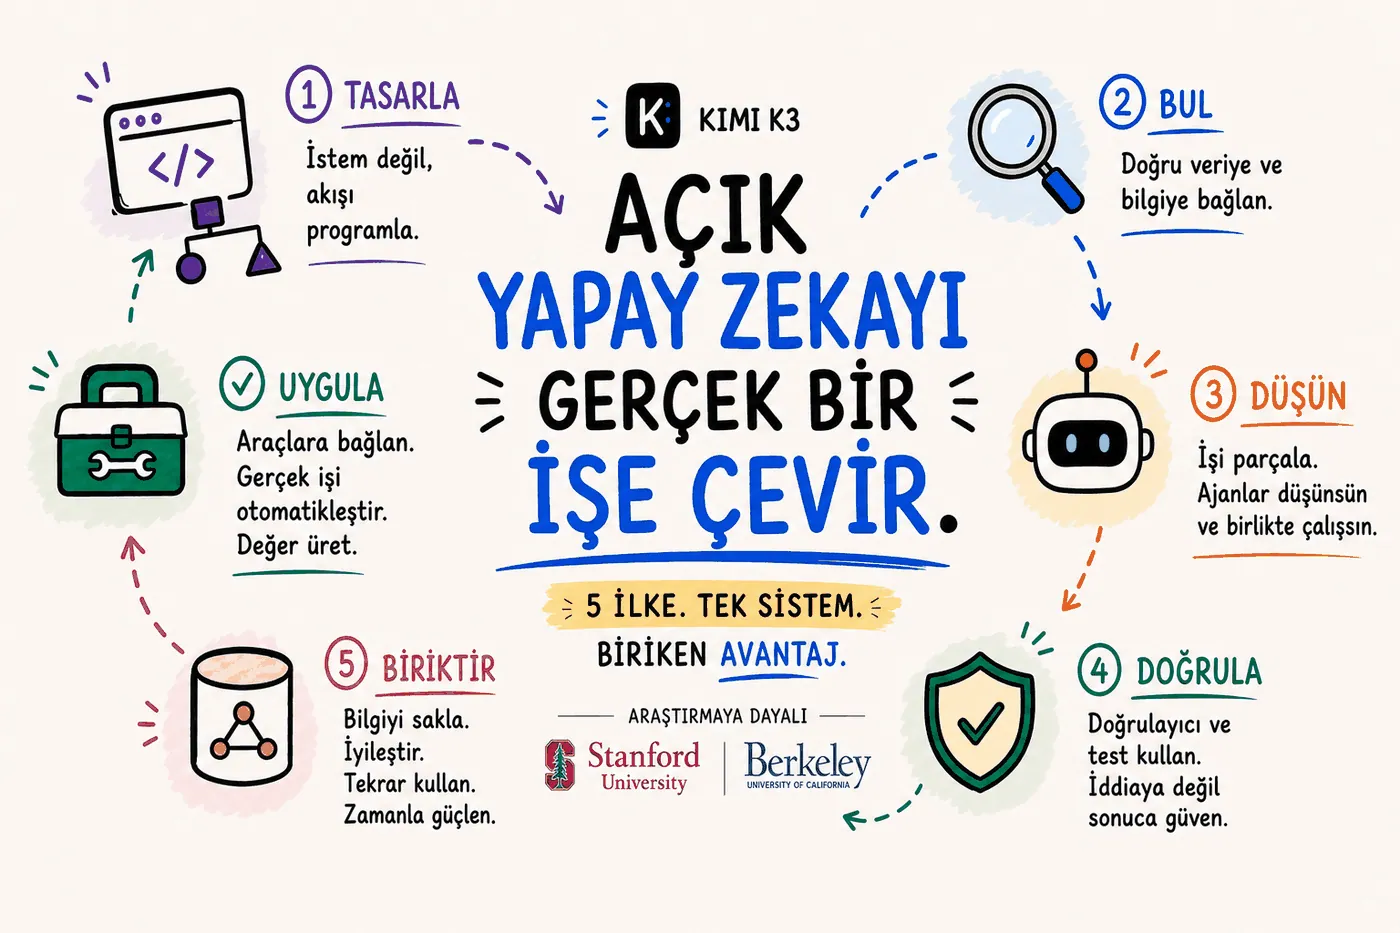
Kapalı bir modele erişimin olması gerekmiyor. Stanford ve Berkeley, güvenilir çalışan sistemlerle demoda kalanları neyin ayırdığını araştırdı ve sonuç beş ilkede toplanıyor: istem yerine akışı programla, modele güvenmek yerine doğrulayıcı kur, ölçeğe değil role göre parçala, uzmanlığı skill dosyalarına yaz ve modeli MCP ile gerçek verine bağla. Sayılarla: çalıştırılabilir şartnamelerle %42,2 Pass@1, melez doğrulayıcılarla %51,0 Best@26; çok ajanlı kurgularda iyileşme 2-4 puan, kötü koordinasyonda tek ajanın altına düşüş.
Hızlı not: Bu yazının en faydalı kısmı ajan sayısıyla ilgili olan: daha fazla ajan otomatik olarak daha iyi sonuç vermiyor, rolleri örtüşen iki ajan tek net görevli ajandan kötü çalışıyor.
Anthropic'te çalışman gerekmiyor. 10 milyon dolarlık bir işlem bütçen olmasına gerek yok. Kimsenin erişemediği kapalı bir sınır modeline erişimin olmasına da gerek yok.
Stanford ve Berkeley, güvenilir çalışan yapay zeka sistemleriyle demoda etkileyici görünüp üretimde çöken sistemleri tam olarak neyin ayırdığını yıllarca araştırdı. Bulguları yayınladılar. Herkes okuyabilir. Çoğu insan okumuyor.
Bir sonraki dalgayı kazanacak şirketler en iyi model erişimine sahip olanlar değil. Herkese açık modelleri güvenilir sistemlere çevirenler: rakiplerin kolayca kopyalayamayacağı özel iş akışları, kendi verisi, değerlendirme döngüleri ve zamanla biriken kurum bilgisiyle.
Model bir motor. Aşağıdaki beş ilke ise sistemin kendisi.
İlke 1: İstem yazma, akışı programla
Stanford'daki araştırmacılar çoğu insanın dil modellerini nasıl kullandığına baktı ve temel problemi tespit etti: her daha iyi istem yazışında elle optimizasyon yapıyorsun. Tek bir girdiyi tek bir çıktı için ayarlıyorsun. Bu ne ölçekleniyor ne de birikiyor.
Önerilen zihin modeli tamamen farklı: istem yazma, program yaz. Akışı modüllerden oluşan bir dizi olarak tanımla: araştırma, getirme, akıl yürütme, doğrulama, çıktı. Sonra tanımladığın bir metriğe göre her modülün istemini sistemin kendisi optimize etsin.
import dspy

# Akışını bir program olarak tanımla
class ArastirmaHatti(dspy.Module):
    def __init__(self):
        self.arastir = dspy.ChainOfThought("konu -> temel_bulgular")
        self.karsilastir = dspy.ChainOfThought("bulgular -> karsilastirma")
        self.dogrula = dspy.ChainOfThought("karsilastirma -> dogrulanmis_cikti")

    def forward(self, konu):
        bulgular = self.arastir(konu=konu)
        karsilastirma = self.karsilastir(bulgular=bulgular.temel_bulgular)
        sonuc = self.dogrula(karsilastirma=karsilastirma.karsilastirma)
        return sonuc

# Bütün hattı otomatik optimize et
optimizer = dspy.BootstrapFewShot(metric=senin_metrigin)
optimized = optimizer.compile(ArastirmaHatti(), trainset=orneklerin)
Uygulamaya döktüğünde şuna benziyor:
Kullanıcı sorusu
↓
Araştırma modülü    - ilgili bilgiyi bulur
↓
Getirme modülü      - belirli veri noktalarını çeker
↓
Akıl yürütme modülü - analiz eder ve karşılaştırır
↓
Doğrulayıcı modül   - çıktıyı kontrol eder
↓
Nihai cevap
Model artık sohbet asistanı olmaktan çıkıp programın içindeki bir modüle dönüşüyor. Hat kararlı çalışıyor, optimize edici daha fazla örnek gördükçe kalite birikiyor ve istemler kendiliğinden iyileşiyor.
Stanford'un deneyleri, derlenmiş hatların hem standart birkaç örnekli istemi hem de uzman eliyle yazılmış örnekleri karmaşık çok adımlı işlerde geçtiğini gösterdi.
Pratik ürün karşılığı: soruları cevaplayan değil, her seferinde aynı kararlı hattı izleyen bir analist. Araştır, karşılaştır, hesapla, doğrula, raporla.
İlke 2: Modele güvenme, doğrulayıcı kur
Berkeley'deki araştırmacılar yazılım mühendisliğinin neden ajanlar için mükemmel alan olduğunu tespit etti. Kod kolay olduğu için değil; kodun nesnel geri bildirimi olduğu için.
Derleyici ya kabul eder ya reddeder. Testler ya geçer ya kalır. Tip denetleyicisi ya hata bulur ya bulmaz. Bunlara doğrulayıcı deniyor: ajanın çıktısını insan yargısı olmadan değerlendirebilen sistemler.
Ortam ve doğrulayıcı, bir ajanın hangi işleri güvenilir biçimde öğrenebileceğini belirliyor. Doğrulayıcısı olmayan güçlü bir model, kendinden emin çöp üretir. Güçlü doğrulayıcısı olan orta seviye bir model, güvenilir çıktı üretir.
DOĞRULAYICI YOKKEN:
Model kodu yazar
→ doğru olduğunu iddia eder
→ bilmenin bir yolu yok
→ elle incelersin
→ hataları kendin bulursun

DOĞRULAYICI VARKEN:
Model kodu yazar
↓
Test koşucusu çalıştırır
↓
DÜŞTÜ - net hata mesajı döner
↓
Model hatayı okur
↓
Model düzeltir
↓
Test koşucusu tekrar çalıştırır
↓
GEÇTİ - nesnel kanıtla doğrulandı
def dogrulayicili_ajan_dongusu(gorev, istemci, max_tur=5):
hatalar = ""
for tur in range(max_tur):
# Ajan çözümü yazar
cozum = istemci.complete(
prompt=f"Uygula: {gorev}\nÖnceki hatalar: {hatalar}"
)
# Doğrulayıcı nesnel olarak kontrol eder
sonuc = testleri_calistir(cozum.kod)
if sonuc.hepsi_gecti:
return cozum # doğrulanmış
# Hata kanıtını ajana geri besle
hatalar = sonuc.hata_detaylari
return None # insana yükseltBerkeley'nin çalıştırılabilir şartnameler üzerine araştırması bunu daha da ileri götürdü: test kümelerini pekiştirmeli öğrenmede ödül olarak kullanan bir sistem SWE-Bench Verified üzerinde %42,2 Pass@1'e ulaştı. Yürütmeye dayalı melez doğrulayıcılar ise %51,0 Best@26'ya çıktı.
Kurma biçimini değiştiren ilke şu: modele çıktısının doğru olup olmadığını sorma, bunu kanıtlayan bir ortam kur.
Kullanıcı ihtiyacı
↓
Model ÖNCE kabul testlerini yazar
↓
Model özelliği uygular
↓
Testler otomatik çalışır
↓
Varsa hata kanıtı geri döner
↓
Model net hata bağlamıyla onarır
↓
Testler geçer → doğrulanmış şekilde biter
İyi bir yapay zeka mühendisi koddan başlamaz. Makinenin kontrol edebileceği bir "bitti" tanımından başlar.
İlke 3: Dev tek ajan kullanma, akıllıca parçala
Stanford'un çok ajanlı sistemler üzerine araştırması önemli ve genelde atlanan bir şey gösterdi. Çok ajanlı kurgular karmaşık araştırma işlerinde tek ajanlı sürümleri tutarlı biçimde geçti. Ama iyileşme ölçülüydü: yaklaşık 2 ile 4 puan. Dahası CooperBench'te birlikte çalışan iki kodlama ajanı, koordinasyon hataları yüzünden bazen tek ajandan daha kötü performans gösterdi.
YANLIŞ:
300 ajan
→ otomatik olarak 300 kat daha iyi çıktı

DOĞRU:
Doğru parçalama
+ net roller
+ ortak durum
+ bağımsız doğrulama
→ güvenilir iyileşme
Berkeley'nin ölçeklenebilir ve kendini geliştiren ajanlar çerçevesi ajanları ölçeklemenin üç yolunu tarif ediyor:
Sıralı    |  ajan tek bir iş üzerinde daha uzun çalışır
Paralel   |  birden çok ajan farklı parçalar üzerinde aynı anda çalışır
Özyineli  |  ajanlar alt görevler için yeni alt ajanlar başlatır
Ama önemli olan değişken ajan sayısı değil, parçalamanın kalitesi.
BİR ARAŞTIRMA RAPORU İÇİN DOĞRU PARÇALAMA

Yönetici ajan     |  kapsamın tamamını anlar, işi dağıtır
Araştırma ajanı   |  kaynakları bulur, ham bilgiyi çeker
Rakip ajanı       |  rekabet ortamını analiz eder
Finans ajanı      |  rakamları çeker ve yorumlar
Doğrulama ajanı   |  iddiaları kaynaklara karşı kontrol eder
Yazar ajanı       |  hepsini tutarlı bir metinde birleştirir

Her ajanın net girdisi, net çıktısı ve net kapsamı var.
Hiçbir ajan diğerinin işini tekrarlamıyor.
Her adımdan sonra ortak durum dosyası güncelleniyor.
Nihai çıktıdan önce bağımsız doğrulama yapılıyor.

YANLIŞ PARÇALAMA

5 ajan da "araştırma" yapıyor
→ tekrarlanan iş
→ çelişen çıktılar
→ net bir sentez yok
→ tek ajandan daha kötü
Ölçeğe göre değil, role göre parçala.
İlke 4: Uzmanlığı tekrar anlatma, skill olarak kodla
Aynı kuralı ajana her seferinde yeniden anlattığında birikmesi gereken bir değeri kaybediyorsun. Sıfırdan başlayan her oturum, buharlaşan kurum bilgisi demek.
Skill'ler bunu doğrudan çözüyor. Skill, içinde bir SKILL.md olan bir klasör: iş akışını, standartları, proje kurallarını, alan bilgisini ve inceleme sürecini tutuyor. Model, işin türüne bakıp hangi skill'i devreye alacağına kendisi karar edebiliyor. Kullanıcı ya da proje seviyesinde saklanabiliyor, argüman alabiliyor ve üç seviyeye kadar iç içe geçebiliyor.
SaaS açılış sayfası kuran bir şirket için gerçek bir örnek:
---
name: acilis-sayfasi-uretimi
description: Dönüşüm odaklı SaaS açılış sayfaları kurar
whenToUse: Yeni açılış sayfası ya da yeniden tasarım istendiğinde
---

# Açılış Sayfası Üretimi

## Adım 1 - Müşteri analizi
Hedef müşteri segmentini belirle.
Brifingten en önemli üç acıyı çıkar.
Her acıyı belirli bir ürün özelliğine bağla.

## Adım 2 - Mimari
Hero bölümü: özelliğe değil acıya odaklı başlık.
Varsa sosyal kanıt ilk ekranda.
Tek birincil eylem çağrısı, rakip buton yok.

## Adım 3 - Uygulama
Yığın: Next.js, Tailwind, Server Actions.
Mobil önce. Her şeyden önce 375px'te test et.
Sayfa ağırlığı 200kb altında. Görseller next/image ile.

## Adım 4 - Kalite kapıları
Lighthouse skoru bütün metriklerde 90 üzeri.
Bütün eylem çağrıları analitik olayıyla izleniyor.
Teslimden önce sıfır konsol hatası.
Kapıların hepsi geçmeden asla yayına alma.

## Kurallar
Asla kaydırmalı bileşen kullanma.
30 saniyeden önce açılan açılır pencere koyma.
Isı haritası takibi kurulmadan yayına alma.
Sonrasında akış şöyle işliyor: müşteri brifingi geliyor, model brifingi okuyor, skill'i kendisi devreye alıyor, senin standartlarını her seferinde aynı şekilde uyguluyor. Hiçbir şeyi yeniden anlatmadan tutarlı çıktı.
Biriken etki ciddi. Birinci hafta skill'i yazıyorsun. İkinci hafta kendiliğinden çalışıyor. Üçüncü ay neyin işe yarayıp yaramadığına göre inceltilmiş oluyor. Altıncı ayda çoğu yeni ekip üyesinden fazla kurum bilgisi taşıyor.
İlke 5: Yapay zekayı sohbette tutma, araçlara bağla
Sadece sohbet kutusuna yapıştırdığını görebilen bir model, gözü bağlı çalışan bir danışmandır. Ona getirdiğin bilgi üzerine akıl yürütebilir ama işinin, verinin ve sistemlerinin gerçek durumunu göremez.
MCP tam olarak bu bağı kuruyor: modelin dış araçlara stdio, HTTP ve SSE üzerinden bağlanması. Yapacağını anlatan ajan ile yapan ajan arasındaki fark bu.
MCP YOKKEN:
Sen → veriyi sohbete yapıştır → model analiz eder → çıktıyı kopyala → uygula

MCP VARKEN:
Model → CRM'ini doğrudan okur
      → veritabanını sorgular
      → açık issue'lara bakar
      → destek taleplerini çeker
      → analiz eder ve sentezler
      → canlı veriyle rapor üretir
      → ilgili kayıtları günceller
      → özeti ekip kanalına gönderir
Somut bir iş senaryosu: "bu ay satışlar neden düştü?" MCP olmadan CRM verisini dışa aktarır, gelir verisini çeker, destek konularını çıkarır, hepsini yapıştırır, analizi bekler ve çıktıyı rapora kopyalarsın. MCP ile model bütün kaynakları aynı anda okur, sistemler arası kalıpları karşılaştırır, kök sebepleri kanıtla birlikte belirler ve raporu somut veri noktalarıyla üretir.
GitHub     |  repoları, issue'ları, PR'ları ve commit geçmişini okur
Linear     |  kayıtları okur ve günceller, PR'larla ilişkilendirir
Postgres   |  canlı iş verisini doğrudan sorgular
CRM        |  satış hattını, anlaşma durumunu, müşteri geçmişini okur
Dosya      |  yerel dosyaları ve ayarları okur ve yazar
Slack      |  özet gönderir, eskalasyonda haber verir
Savunulabilir hale gelen dikey yapay zeka ürünü, MCP üzerinden gerçek iş verisine bağlı olandır. Model herkese açık. Veri senin. Bağlantılar da senin hendeğin.
Sistemin tamamı
Beş ilkeyi bir araya koyduğunda mimari netleşiyor:
                   SENİN ÜRÜNÜN
                        │
                        ▼
                      MODEL
                        │
          ┌─────────────┼─────────────┐
          ▼             ▼             ▼
        SKILL         HAFIZA         MCP
   kodlanmış uzmanlık ortak durum  gerçek araçlar
   tekrarlanabilir süreç  devirler  canlı veri
          │             │             │
          └─────────────┼─────────────┘
                        ▼
                 PROGRAMLANMIŞ HAT
                    planla → uygula → doğrula
                        │
               ┌────────┴────────┐
               ▼                 ▼
         DÜŞTÜ ↺ tekrar     GEÇTİ → çıktı
                                  │
                                  ▼
                             kayıt + ilerleme
                             sonraki tur
Beşini birbirine bağlayan ilke
Stanford programlanmış hatların istem verilen modelleri geçtiğini gösterdi. Berkeley doğrulayıcıların model zekası kadar önemli olduğunu kanıtladı. Stanford'un yapay zeka endeksi koordinasyon kalitesinin çok ajanlı sistemlerin fayda mı zarar mı vereceğini belirlediğini ortaya koydu. Skill'ler zamanla biriken kurum bilgisini kodluyor. MCP ise modeli dünyanın gerçek durumuna bağlıyor.
Hepsi tek bir sonuca işaret ediyor: bir sonraki değerli yapay zeka şirketi, muhtemelen gizli bir modele erişimi olduğu için kazanmayacak. Herkese açık bir modeli güvenilir bir sisteme çevirdiği için kazanacak. Rakiplerde olmayan alan uzmanlığını kodlayan skill'ler. Modele başkasının erişemeyeceği bağlamı veren özel veri. Her çıktıyı insan incelemesine gerek bırakmadan kaliteyi garanti eden değerlendirme döngüleri. Ve çalıştıkça değeri artan iş akışları.
Sistem üründür. Model, onun içindeki motordur.
Geliştiricilerin çoğu herkese açık modellerin üstüne sohbet arayüzü kurmaya devam edecek ve neden savunulabilir bir iş çıkmadığını merak edecek. Birkaçı ise yukarıdaki beş katmanı kurmaya vakit ayıracak ve her hafta değeri artan bir şey elde edecek.
- Kazanan taraf en iyi modele erişen değil, açık modeli güvenilir sisteme çeviren.
- İstem yazmayı bırak, akışı programla: iş modüllere bölünsün, süreç dosyada dursun.
- Modele güvenme, doğrulayıcı kur. Testi geçmeyen iş bitmiş sayılmaz.
- Ajanları ölçeğe göre değil role göre parçala; örtüşen roller tek ajandan kötü sonuç veriyor.
- Uzmanlığı skill'e yaz, modeli MCP ile gerçek verine bağla. Kopyalanamayan kısım bu.
5 maddede özet
- Akışı programla: düzelttiğin şey istem değil süreç olsun.
- Bitti tanımı makinede olsun: önce kabul testi, sonra kod.
- Role göre parçala: çok ajanlı kurgu ancak net rollerle kazandırıyor.
- Skill birikir: altıncı ayda çoğu yeni üyeden fazla kurum bilgisi taşır.
- Veri senin: MCP bağlantıları savunma hattının kendisi.